
摩尔线程重磅发布MTT AICUBE:搭载全域智能体“小麦”,打造家庭AI中枢
5月18日,摩尔线程举办2026产品发布会,宣布全面深化端侧AI战略布局,并重磅发布首款面向家庭场景的消费级产品——MTT AICUBE(以下简称:AICUBE)。为满足词元(Token)时代爆发的端侧算力需求,摩尔线程立足自研“长江”智能SoC,实现了算力从
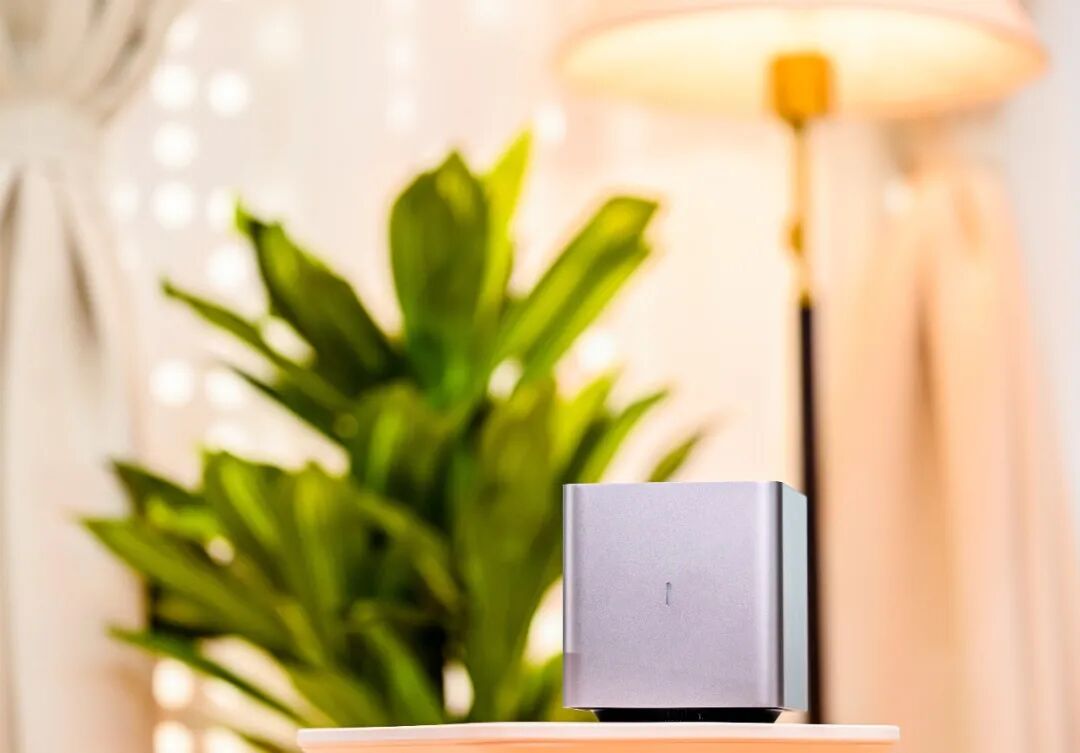
5月18日,摩尔线程举办2026产品发布会,宣布全面深化端侧AI战略布局,并重磅发布首款面向家庭场景的消费级产品——MTT AICUBE(以下简称:AICUBE)。为满足词元(Token)时代爆发的端侧算力需求,摩尔线程立足自研“长江”智能SoC,实现了算力从
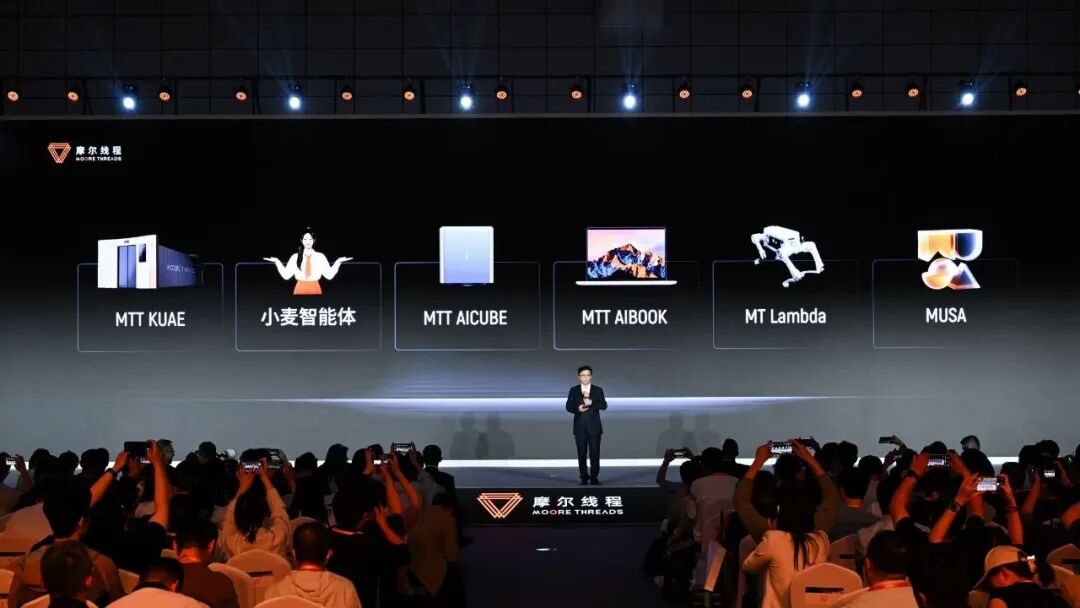
5月18日,摩尔线程在北京举办主题为“词元时代,万物智能”的产品发布会。在Agentic AI驱动词元(Token)需求呈指数级跃升的关键节点,万物智能处于爆发前夜,算力的基石作用愈发关键。 摩尔线程在此次盛会上全方位展示了其作为智算底座的战略纵深,全面展示了
5月16日,在杭州市具身智能创新发展大会上,国家人工智能应用中试基地(具身智能)(简称:国家具身智能应用中试基地)正式揭牌,摩尔线程成为共建合伙人,并担任其产业委员会委员。 摩尔线程成为国家具身智能应用中试基地共建合伙人 为进一步深化合作,摩尔线程与国家具身智
第二届浦江AI学术年会期间,上海人工智能实验室(上海AI实验室)联合多家科研机构、运营商和大模型企业,共同发起AI全环节软硬件验证合作计划,并拟于今年发布AI全环节软硬件验证平台(验证平台),分场景建设自主AI软硬件能力验证环境,以破解AI软硬件各层次组合复杂
5月13日,以无锡市工业和信息化局、无锡市发展和改革委员会、无锡市数据局及无锡市惠山区人民政府为指导单位,由摩尔线程主办的无锡具身智能产业伙伴思享沙龙成功举行。活动现场,摩尔线程与首批16家联合共建单位签署合作备忘录,正式启动摩尔线程(无锡)工业具身智能创新中
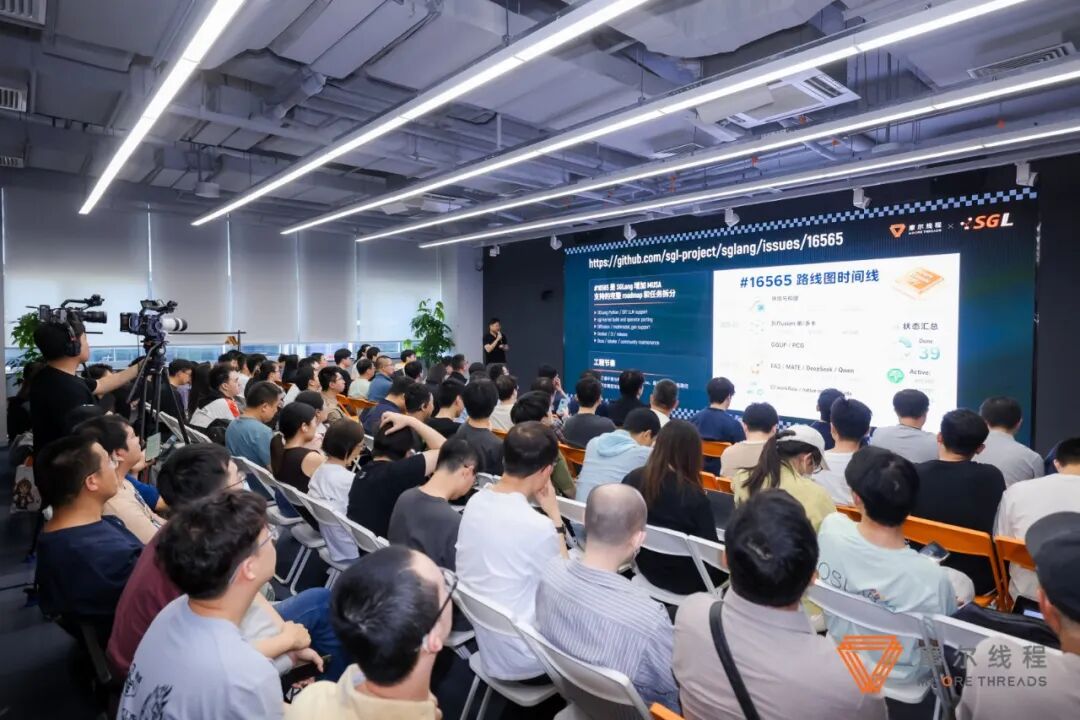
5月10日,由摩尔线程与SGLang社区联合主办的“MUSA开源技术沙龙|SGLang × MUSA Meetup”在北京成功举行。 本次Meetup不仅集结了SGLang核心开发成员,并邀请到TileLang、Triton、Mooncake**等开源社区的顶
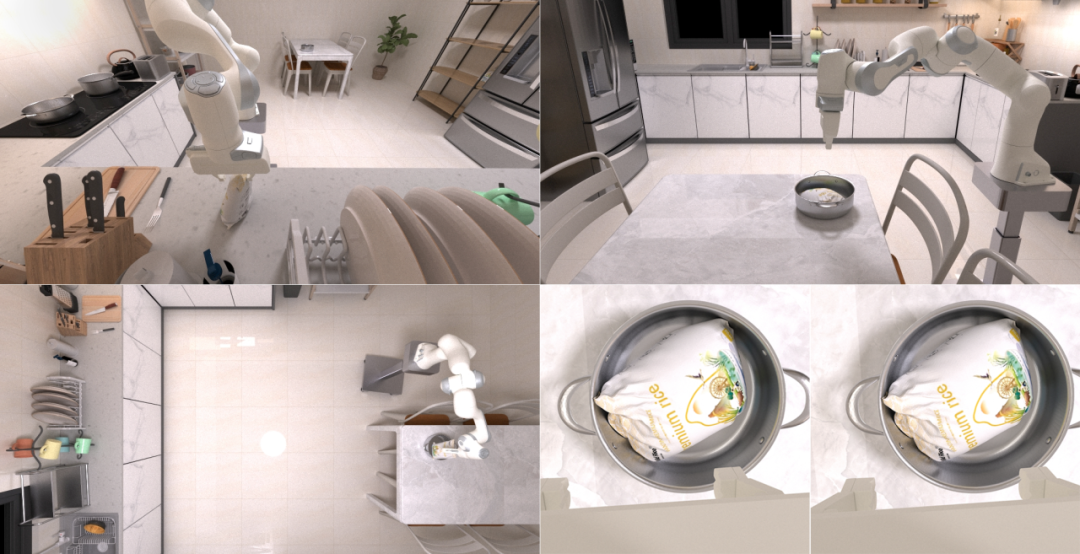
近日,摩尔线程与光轮智能达成战略合作。双方将依托摩尔线程全功能GPU与夸娥(KUAE)智算集群,结合光轮智能“求解—测量—生成”三位一体全栈自研仿真平台,联合打造高置信度仿真数据合成方案,以国产算力与仿真算法的深度融合,为具身智能发展夯实自主可控的基础设施。
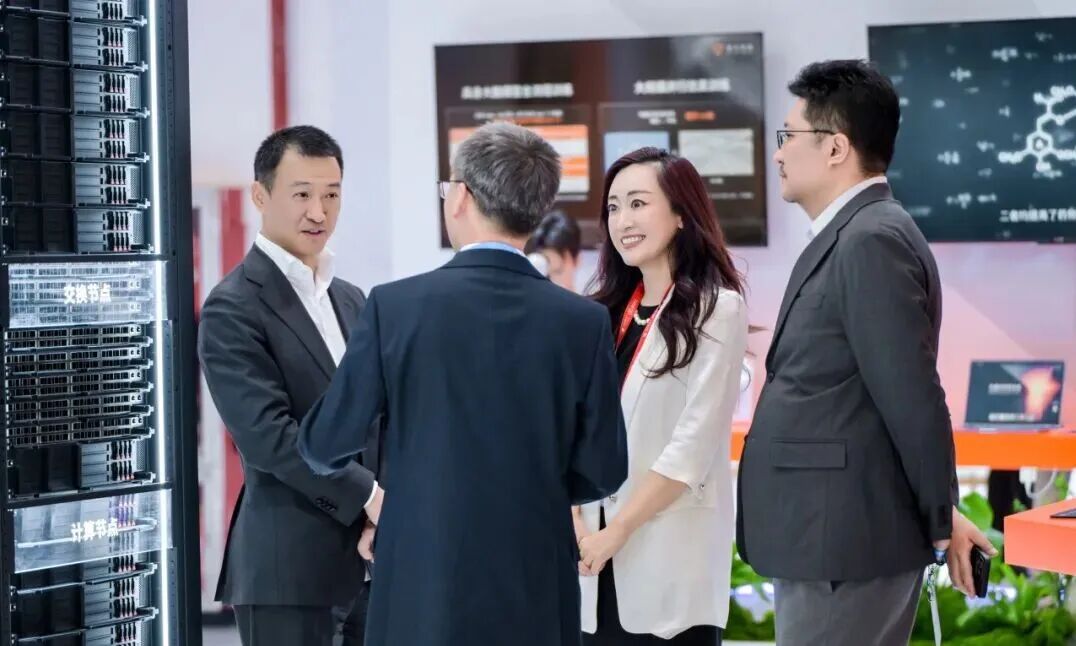
5月7日至9日,2026移动云大会在苏州举行,聚焦算网融合、人工智能、Token应用与产业落地,汇聚政、产、学、研、用各界嘉宾。作为中国移动投资的国产GPU头部企业及核心生态伙伴,摩尔线程携全栈自主算力解决方案参展,并深度参与新品路演、生态发布、圆桌对话等环节
近日,摩尔线程依托旗舰级AI训推一体智算卡MTT S5000与自研MUSA软件栈,基于SGLang 开源推理框架,成功完成DeepSeek-V4的完整运行验证。该成果表明,面向新一代MoE大模型,摩尔线程已构建起从硬件架构核心计算引擎承接、热点算子支持**,*
近日,中国移动自主研发的九天35B通用大模型即将正式发布。作为中国移动重要的生态合作伙伴及 “AI 能力联合舰队” 的核心算力成员,摩尔线程基于旗舰级AI训推一体全功能GPU MTT S5000,依托成熟的MUSA软件栈与高性能算子优化,已率先完成九天35B模
4月24日,摩尔线程联合北京智源人工智能研究院,基于旗舰级AI训推一体智算卡MTT S5000与FlagOS全栈软件体系,**完成DeepSeek-V4系列两款模型推理“Day-0”适配,并在魔搭社区正式发布Pro和Flash两个版本的镜像**,为开发者与行业
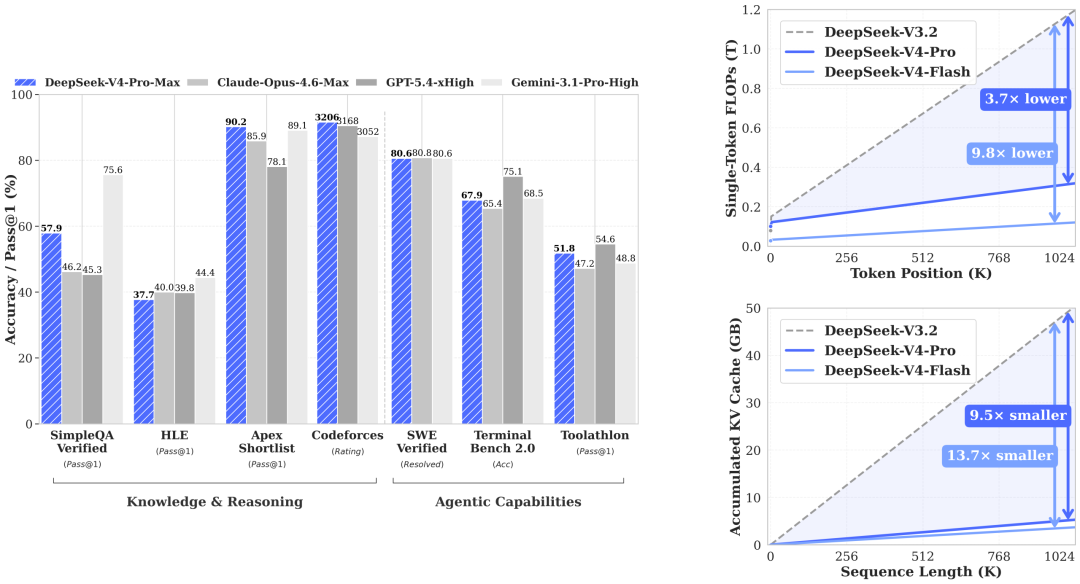
4月24日,摩尔线程携手智源众智FlagOS社区,在旗舰级AI训推一体全功能GPU MTT S5000上,率先实现对新一代大模型DeepSeek-V4-Flash的Day-0极速适配,并完成了全量核心算子的深度优化与部署支持。 DeepSeek-V4-Fla
4月24日,摩尔线程宣布,其基于TileLang 0.1.8版本深度优化并已成为TileLang官方主线版本的TileLang-MUSA,已率先在国产全功能GPU上,实现对DeepSeek-V4最新TileLang算子库TileKernels的“Day-0”支
今日,DeepSeek-V4预览版正式发布并开源。摩尔线程携手上海 AI 实验室 DeepLink 团队,通过大模型驱动的智能算子迁移系统 KernelSwift,率先在旗舰级AI训推一体智算卡 MTT S5000 上完成了核心算子的Day-0适配。目前算子通
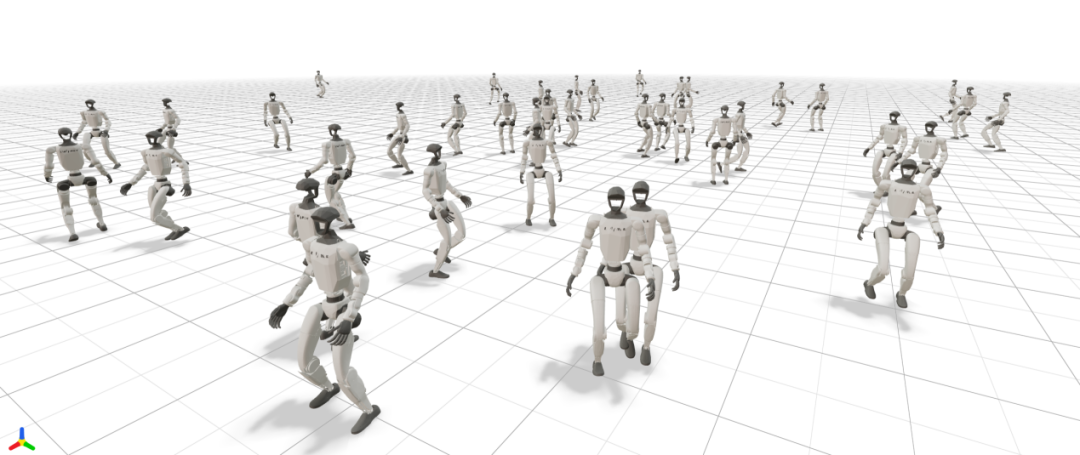
3月30日,摩尔线程正式开源MuJoCo Warp MUSA。这是具身智能领域首个基于MUSA架构的全功能GPU加速物理仿真后端,补齐了国产算力在强化学习仿真训练底层生态中的关键一环。 长期以来,大规模强化学习仿真训练高度依赖单一国际算力架构。尤其在机器人运控

3月31日,北京量电融合产业创新中心正式成立,由中电信量子作为控股股东,联合通明湖信息城、中科弧光、伊辛智能、玻色量子、正则量子、摩笔生成、中兴通讯、国光量超、量坤科技9家单位共同出资组建。创新中心深度汇聚并整合各股东企业在量子计算、智能计算、高速互联等行业领

今日,摩尔线程在其旗舰级AI训推一体全功能GPU MTT S5000上,成功实现了对智谱新一代旗舰模型GLM-5.1的Day-0极速适配,提供推理部署和训练复现全流程支持。 依托MUSA软件栈强大的生态兼容性,摩尔线程技术团队基于高性能 SGLang-MUSA

4月12日,摩尔线程旗舰级AI训推一体全功能GPU MTT S5000已完成对新一代大模型MiniMax M2.7的Day-0极速适配,再次验证了国产全功能GPU对前沿AI大模型的快速响应与稳定支撑能力。 图示:MiniMax M2.7在MTT S5000上运