国产AI,已到了生死存亡时刻
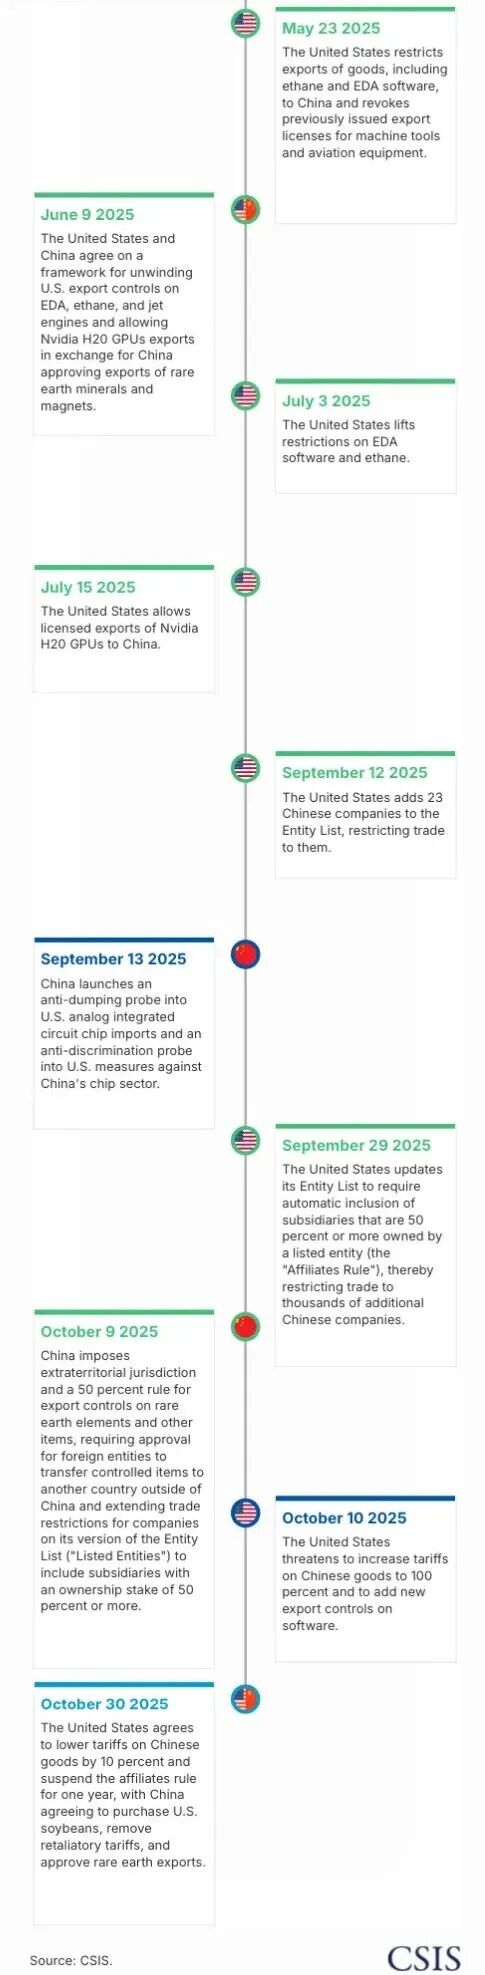
2026年11月,国内AI产业迎来最严峻的关口。美国商务部工业与安全局(BIS)发布《限制远程获取先进半导体》临时最终规则,将出口管制从"芯片实物跨境"延伸到"远程算力访问",新加坡、马来西亚、泰国、印尼、巴西被列为高风险区域,海外数据中心向中国主体提供超过1200万聚合TPP的算力需提前取得美国许可,存量租赁也需在90天内申请许可。英伟达同时向客户发出警告,若超过50%的GPU算力出租给受限公司,将停止供货。
这条通道过去两年并非"补充",而是命脉。最典型的案例是腾讯与甲骨文的算力租赁协议——2026年9月底,双方签署了一份为期五年、涉及约10万颗先进AI芯片、总金额约70亿美元的租赁意向协议,计划通过甲骨文位于东南亚的数据中心获取算力支持。仅仅一个多月后,11月4日,甲骨文正式取消了这笔交易,原因是美国政府官员向甲骨文表达了担忧。这是腾讯迄今规模最大的海外算力租赁交易,它的告吹标志着"借船出海"路径被从制度层面封死。
马化腾在2026年11月11日腾讯28周年LinkTime上要求所有核心业务面向AI时代"再创业",组织扁平化,一半人守存量,一半人打新战役。
腾讯混元模型进入国内第一梯队;WorkBuddy上线8个月内成为国内提供最多token的单一AI产品;微信AI助理"小微"已落地。
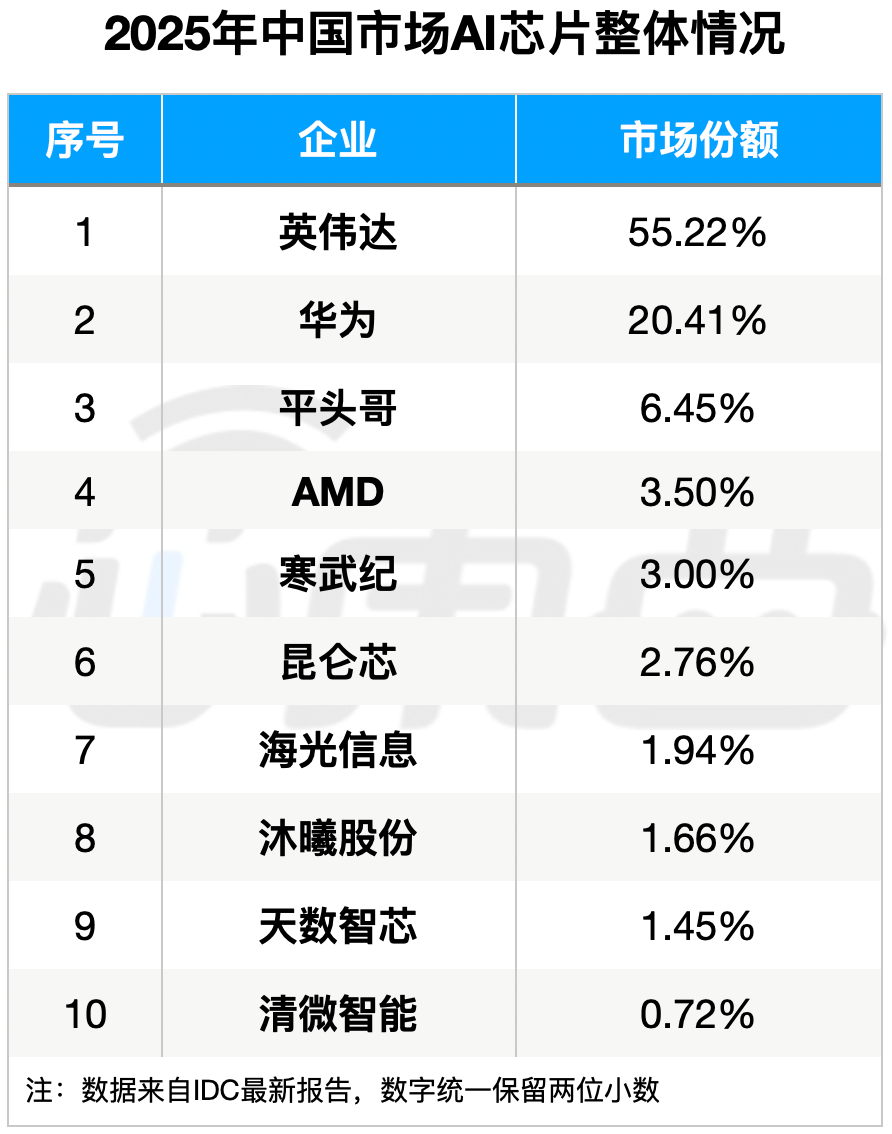
推理阶段模型权重固定,本土芯片已能接住流量。IDC数据显示,2026年上半年中国数据中心AI加速器总出货约200.8万颗,其中华为昇腾出货57.2万颗,份额28%,与英伟达(34%)差距仅6个百分点;非GPU加速器出货101.6万颗,同比增长近80%,首次超过GPU。赛迪顾问数据更显示,2026年Q1国产AI推理芯片市占率首次突破50%,达52.3%,其中华为昇腾占37%。
但预训练要求万卡集群在数月内以极高带宽进行毫秒级同步,对单卡性能、互连带宽、软件栈稳定性的要求是"乘法关系"。训练芯片市场仍是英伟达主导——2026年Q1英伟达在中国AI训练芯片市场份额仍高达71%,华为昇腾约18%。国产芯片在训练可靠性和软件生态上与CUDA仍有2-3年差距。
DeepSeek创始人梁文锋2026年8月坦言,受算力资源硬性限制,DeepSeek目前拥有约两万张H等效算力,落后美国12到18个月;国产算力卡可用数量仅约一万六千张,难以支撑超大参数模型完整训练迭代。Kimi K3在2026年7月发布后三天就因用户请求量逼近集群承载极限,被迫暂停C端新用户订阅。2026年11月,DeepSeek又因"算力不足"限制长对话、压缩单次输入上限,部分用户不到两小时即耗尽额度。这些都是算力硬约束的直接体现。
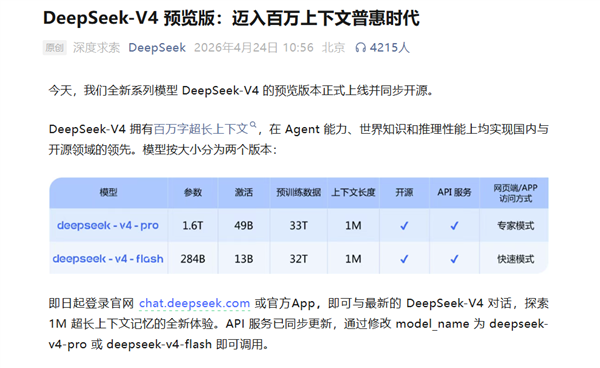
2026年下半年,国内旗舰模型发布明显减速。十一假期国内模型圈罕见"静悄悄"——DeepSeek V4.1 Pro迟迟未至,豆包2.2一再延期,智谱、月之暗面、阿里、腾讯等厂商都没有在假期掀起新的发布大战。上一轮让人眼前一亮的国产旗舰,还要追溯到7月中旬的Kimi K3、7月下旬的DeepSeek V4和Qwen 3.8。
高端GPU供应紧张,去年靠囤货缓冲的效应今年已明显体现。DeepSeek、Kimi等头部厂商的算力硬约束已在前文详述。更深层的问题是,国产算力集群的算力利用率(MFU)普遍在35%左右,而英伟达集群可达80%以上——同样的芯片数量,实际可用算力打了折。这意味着,即便国产芯片纸面参数追平,系统级效率的差距仍使训练成本居高不下。
过去两年,国内很多模型通过蒸馏海外前沿模型快速跟进打榜。但自Anthropic Opus 4.7之后,海外头部模型大幅加强了防蒸馏保护。OpenAI和Anthropic在订阅端和非定向API端都部署了大量反蒸馏措施,完整推理链只有深度合作企业的API才能拿到。据2026年10月初的行业讨论纪要,蒸馏难度明显变高,短期蒸馏成本上升5到10倍,多则20倍;替代方案效果都不如直接蒸馏。反蒸馏后,中美模型差距预期从3-4个月拉长到约12个月;若海外明年实现RSI(递归自我改进),可能进一步拉到18-24个月。
旗舰模型再往上堆参数和算力,跑分提升有限但成本飙升。coding和agent benchmark已刷到90%以上,再卷意义不大;而前沿进步方向转向空间理解、computer use、视频生成,这些领域很难反向拿到完整训练数据。厂商更倾向于打磨专项模型和高速版本,而非一味追求"最大参数"。
与国内发布减速形成鲜明对比的是,海外头部厂商仍在高频迭代,且竞争焦点已从"跑分"转向"能交付的工程结果"。
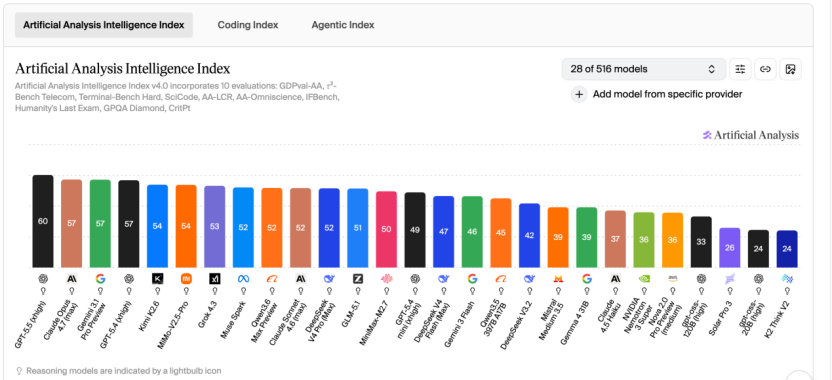
•Anthropic:2026年11月9日发布Claude Fable 5.2和Mythos 5.2,在编码、推理、视觉等方面均有提升,API价格较前代下降20%(输入8美元/百万Token、输出40美元/百万Token),生成速度最高提升30%。据Artificial Analysis数据,截至11月14日,Claude Fable 5.2(max)在全球大模型性能排名中位列第一(智能指数65)。1000个Agent协同8天从零写出带内核和驱动的完整操作系统,30小时完成费马大定理形式化证明。
•OpenAI:2026年6月推出GPT-5.6,提供Sol、Terra、Luna三个分层模型,分别对应旗舰高性能、均衡商用、轻量化高性价比定位。Sol定价输入5美元/百万Token、输出30美元/百万Token,整体仅为Claude Mythos/Fable 5调用成本的一半至三分之一。
•Google:2026年11月10日推出Gemini Robotics 2.5,是谷歌迄今能力最强的视觉-语言-动作(VLA)模型;11月12日发布Gemini 4 Hydrogen,面向日常编程和智能体工作流;11月11日正式向公众发布Gemini 4 Carbon,面向复杂、长周期任务,在Artificial Analysis榜单上以60分位列第二。
•生态整合:谷歌在Gemini Business企业智能体中同时接入Claude Opus 5和Sonnet 5.5,马斯克也宣布Grok Bot接入Claude Opus 5.5。
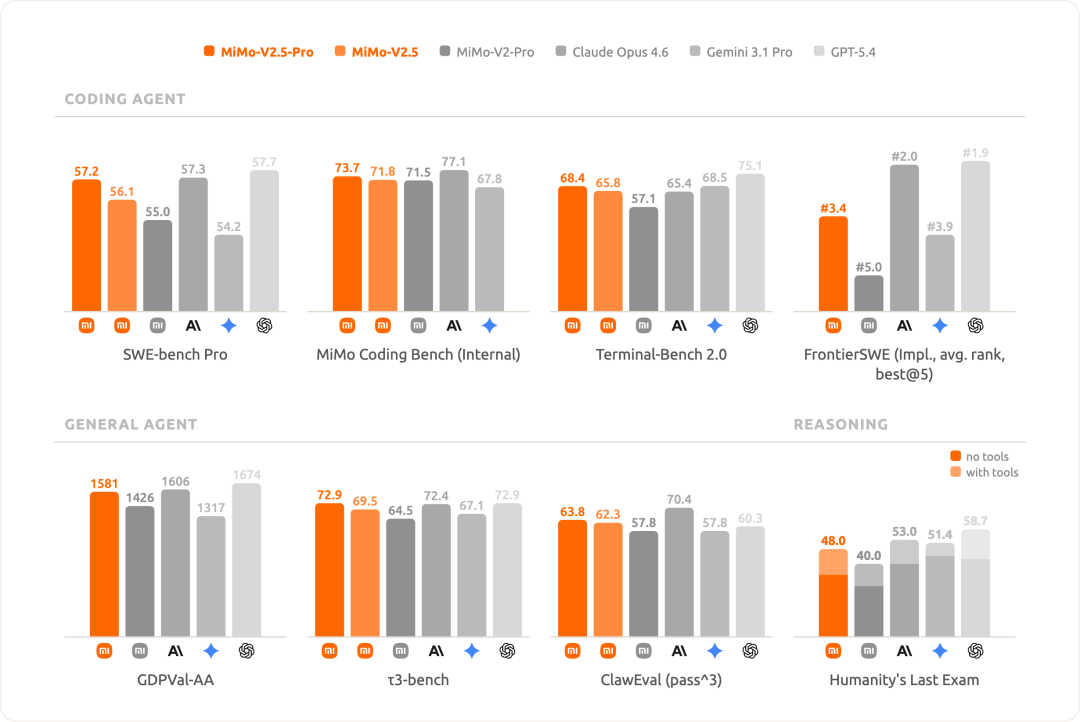
截至2026年11月中旬,Artificial Analysis全球性能榜上,Claude Fable 5.2(max)位列第一,Gemini 4 Carbon(high)第二,Claude Opus 5.5(max)第三,国产最强的Kimi K3.1 Pro排在第十一位。Epoch AI数据显示,中国头部模型训练算力年增速约3倍,慢于全球其他地区5倍的趋势,按当前速率需约两年才能追平全球顶尖水平。
全球调用量:中国模型"量"领先,但"价"和"利"仍落后
OpenRouter统计显示,2026年10月19日至25日那一周,全球模型调用量前五清一色是中国公司:DeepSeek V4.1 Flash一家消耗33.6万亿Token,DeepSeek V4.1 Flash 18万亿,MiniMax M3.1 Flash 13.7万亿,智谱GLM-5.3 Flash 13.2万亿,腾讯混元Hy4 preview 8.97万亿。中国模型一周消耗93.54万亿Token,达到美国22.47万亿的4.16倍,这样的领先已持续26周。
中国模型在OpenRouter上的调用量优势,很大程度上建立在价格优势之上。据Artificial Analysis测算,Kimi K3完成一个任务的平均成本为2美元,Claude Fable 5.1则需7.63美元;中国开源模型的价格普遍比美国头部模型低六到九成。高盛Bobby Molavi报告披露,开源权重模型在9月第二周处理了72%的Token流量,却仅获得27%的平台总支出。豆包、通义、文心一言、Kimi等月活合计超6亿,但付费用户比例均低于3%。2026年上半年,中国面向C端的通用大模型应用整体亏损超过180亿元。
•Anthropic:2026年7月底ARR突破650亿美元,较2025年底约90亿美元增长逾七倍,Q2营收超115亿美元;API调用量过去一年同比增长17倍。截至2026年6月,34.4%的美国企业为Anthropic付费,首次超越OpenAI的32.3%。
•OpenAI:截至2026年9月底内部ARR约500亿美元,低于市场此前预期的700亿美元,仍处于大额亏损。
•国内:DeepSeek和Kimi的ARR先后突破10亿美元,智谱上半年API收入占比从15.2%升至86.5%,但整体仍处于亏损换研发的阶段。
OpenRouter统计的主要是开源和可按需替换的模型调用,OpenAI和Anthropic的大量企业API调用走自有渠道,不计入其中。因此,中国模型在"量"上的领先,更多反映的是开源生态和价格优势;而在企业级付费、高复杂度任务交付、每token利润率等维度上,与海外仍有明显差距。
模型层的"军备竞赛"在减速,但应用层正在加速落地。
腾讯首次披露其AI"金字塔"结构:混元模型进入国内第一梯队;小微定位个人AI助理,目标是"token自由";元宝做决策和资讯参谋;WorkBuddy在8个月内成为国内提供最多token的单一AI产品,截至9月月活达3235.3万人,企业版已落地50多个行业,中国500强企业中已有一半在使用。
字节豆包工作2026年8月发布后高频迭代,11月中旬正式上线"工作台",预装21个专业场景技能。阿里千问办公在云栖大会上宣布益海嘉里、一汽丰田等企业接入。IDC数据显示,2026年上半年中国企业市场公有云MaaS总规模106.3亿元,同比增长近9倍,火山引擎以45.1%份额居首。
企业级智能体方面,IDC预计2026年国内活跃企业智能体接近200万个,市场规模从2025年的212亿元升至449亿元。2026年上半年国内五家主要AI云厂商公开披露的大模型中标金额约20.44亿元,其中应用类项目占比接近一半,金融、通信、能源、大交通成为落地最活跃的领域。企业采购标准正在从"买模型"转向"买系统能力"——芯片、云基础设施、模型、智能体平台、行业应用一体化交付。
第一,国产算力预训练降本,从"能用"走向"可规划"。
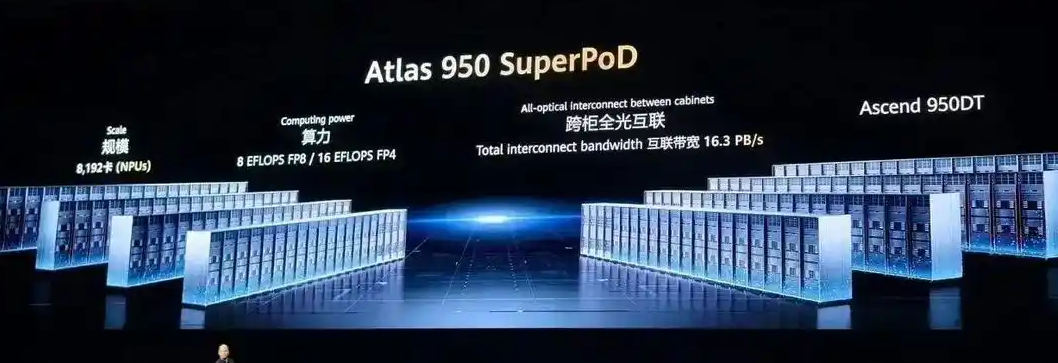
训练侧仍是国产AI最硬的短板,但2026年以来,华为昇腾的迭代节奏明显加快。昇腾950系列已正式上市,昇腾960DT、960PR分别提前至2027年一季度和三季度就绪,未来计划保持一年一代,2028、2029年继续推出昇腾970、980。这意味着国产旗舰芯片从"点状突破"进入"可预期、可规划"的连续演进轨道。
更关键的是,超节点正在用系统级互联弥补单卡差距。由4000卡超节点组成的10万卡集群,模型算力利用率(MFU)可提升约2.75倍;昇腾910C超节点已部署超1000套,昇腾950超节点也进入规模商用。如果国产集群MFU能从目前的35%左右提升到45%—50%,训练总拥有成本(TCO)就会显著下降。
生态侧也在松动。DeepSeek已于2026年9月把面向昇腾的tilelang、deepgemm、deepep、FlashMLA等底层组件开源,与CUDA版一一对应;产业链消息称,DeepSeek下一代模型V5计划基于昇腾开展预训练。如果国产大模型从"推理适配昇腾"进一步走向"原生预训练昇腾",国产算力的天花板将从推理侧实质性抬升到训练侧。
第二,推理侧和边缘侧,是国产芯片最容易率先跑通的战场。
2026年,AI产业正从"训练竞赛"进入"推理规模化落地"。黄仁勋在GTC 2026上判断,推理负载规模将达到训练的十亿倍。
推理侧对单卡极限性能要求低于训练,但对成本、能效、本地部署和信创适配更敏感。IDC数据显示,2026年上半年中国数据中心AI加速器出货约200.8万颗,其中华为昇腾57.2万颗,份额28%;非GPU加速器出货101.6万颗,同比增长近80%,首次超过GPU。赛迪顾问数据也显示,2026年一季度国产AI推理芯片市占率首次突破50%,达52.3%。
边缘AI芯片市场同样快速扩张。2026年中国边缘AI芯片市场规模预计突破210亿元,同比增长38%;爱芯元智、后摩智能、中星微、聆思科技等端侧芯片企业正在加速商业化。智慧城市、智能座舱、工业质检、AI PC、机器人等场景,对数据不出厂、低时延、低功耗有刚性需求,国产芯片在这里不仅能"替代",还能形成差异化优势。
第三,应用层和Agent,正在把"模型能力"变成"企业预算"。
2026年中国企业级AI智能体市场规模预计达到449亿元,2029年有望突破3320亿元。企业采购标准正从"买模型"转向"买系统能力":芯片、云基础设施、模型、智能体平台、行业应用一体化交付。
•阿里Qoder:IDC数据显示,2025年中国AI编程市场份额中,Qoder以47.6%位居第一,超过第二名至第五名之和;截至2026年秋,全球用户超800万,超10万家企业接入。
•实在智能:2026年7月,其实实在Agent在OSWorld榜单上以90.2%任务成功率位列第一,客户超6000家,其中200余家为中国500强。
•腾讯WorkBuddy:上线8个月内成为国内提供最多token的单一AI产品,截至2026年9月月活达3235.3万人,中国500强企业中已有一半在使用。
•致远互联+华为云:CoMi智能体平台+昇腾算力方案已在江铃汽车、多地政务机关落地,交付周期从3个月压缩至35天。
当"养羊场"都能用编程Agent搭建管理系统、合同审批周期从15天缩到5天、月结开票从8分钟缩到30秒时,AI就不再是PPT里的能力,而是企业预算表里的项目。
第四,开源和MoE架构,正在把"性价比"变成结构性优势。
中国大模型在OpenRouter上的调用量优势,并非单纯靠低价,而是建立在架构革新之上。Qwen3.8-Max、腾讯混元Hy4等新一代旗舰普遍采用稀疏MoE架构,万亿参数下每次推理仅激活千亿级参数,再叠加低精度量化、KV缓存、系统级调度优化,推理成本持续下降。
2026年以来,腾讯混元Hy4输入定价仅6元/百万词元,Qwen3.8-Flash压到1元/百万词元,星火X2.5多语言版低至1.6元/百万词元。"九成能力、一成价格"的性价比,扫清了智能体规模化商用最现实的成本障碍。
开源生态也在加速卡位。2026年8月以来,阿里Qwen3.8-Max首次开放权重,腾讯混元开源Hy4 preview,面壁智能开源MiniCPM5-2B,智谱发布GLM-5.3。Hugging Face数据显示,中国开源模型下载量已占全球总量的41%,累计突破百亿次。开源不再是"技术自信"的展示,而是围绕开发者、国产算力和商业化路径的集体卡位。
国产算力在训练侧仍落后英伟达旗舰一代以上,超节点和软件栈仍需持续验证;推理侧份额提升,但高端场景仍依赖生态成熟度;应用层ROI可验证,但多数企业仍处在试点向规模化过渡的阶段;开源调用量领先,但付费转化和每token利润率仍明显低于海外。
1.和讯网:DeepSeek一款大模型单周调用量,登顶全球第一(2026-10-26)
2.36氪:大模型长假静悄悄(2026-10-09)
3.DataLearner AI:AA榜单大模型智能指数与评测排行榜(2026-11-14)

登录后即可参与技术讨论与同行交流
免费注册