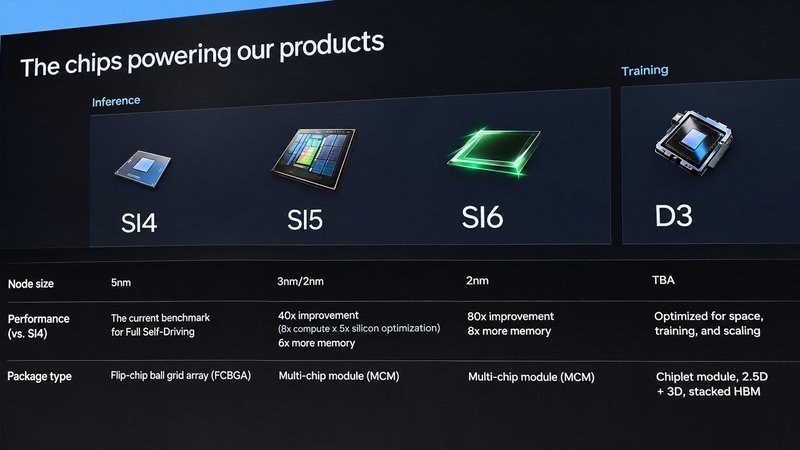
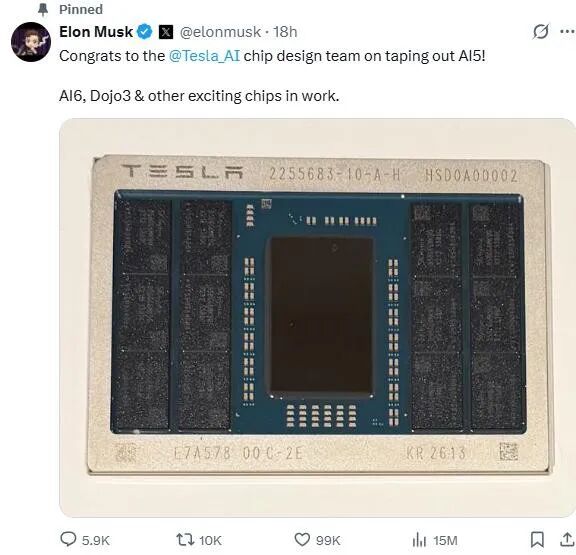
特斯拉披露了其经过调整的AI加速器路线图,揭示了该公司芯片开发工作的未来方向。该公司预计,其第六代推理加速器将带来比现有第四代芯片高80倍的计算性能,而其D3训练加速器将放弃以SRAM为中心的架构,转而采用带有堆叠HBM的多芯粒设计。此外,特斯拉在其AI加速器中采用了“超级智能”一词来替代“人工智能”,并将其重新命名为SI系列。
根据路线图,现有的第三代硬件采用三星14纳米工艺和单片架构,配备8GB LPDDR4内存,算力约为72 TOPS,目前属于传统产品。第四代推理处理器采用三星7纳米工艺和单片架构,配备16GB GDDR6内存,算力估计在216至576 TOPS之间,目前已投入量产。第五代推理加速器计划采用台积电3纳米或三星2纳米工艺,采用多芯片模块架构,内存容量达96GB,算力预计为8640至23040 TOPS,目前接近量产阶段。第六代推理加速器将采用2纳米级工艺和多芯片模块架构,内存容量达144GB,算力预计高达17280至46080 TOPS,目前处于开发阶段。在训练加速器方面,第一代Dojo D1采用台积电7纳米工艺和晶圆级架构,每晶圆配备11GB SRAM,算力约为362 TFLOPS,目前已停产。第三代Dojo D3将采用2纳米级工艺和芯粒架构,结合2.5D与3D封装及堆叠HBM,具体参数待定,目前处于开发阶段。
特斯拉AI硬件路线图中最引人注目的发展之一,是内部开发的Dojo训练加速器的重新回归。此前,马斯克在2025年8月取消了整个晶圆级Dojo项目,并在2026年8月表示SpaceX和xAI将在其地面和太空数据中心独家使用英伟达硬件。然而,第三代Dojo将与前两代Dojo D1和Dojo D2有很大不同。
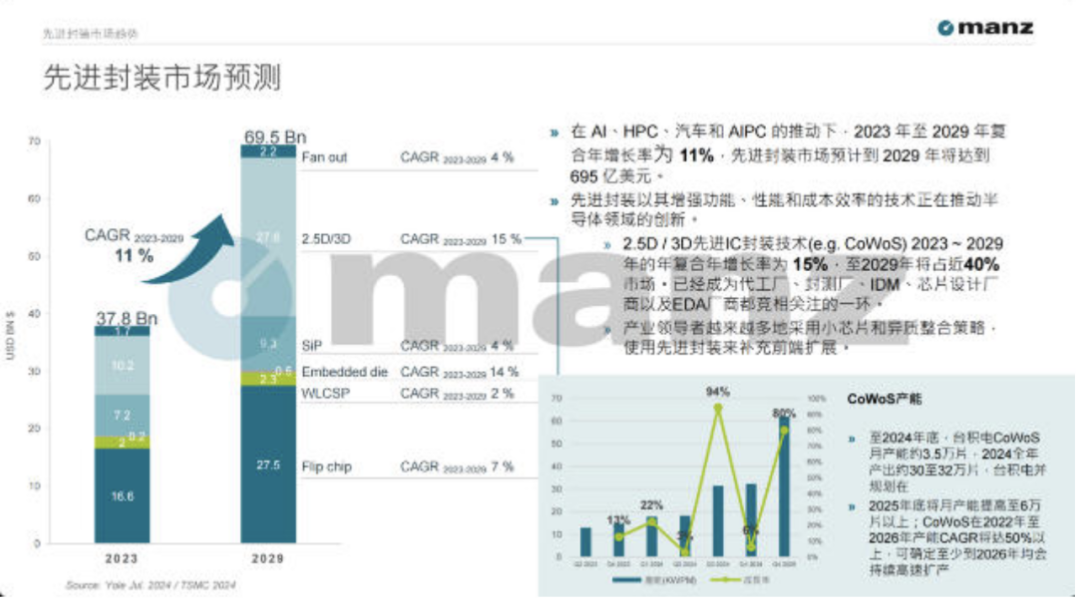
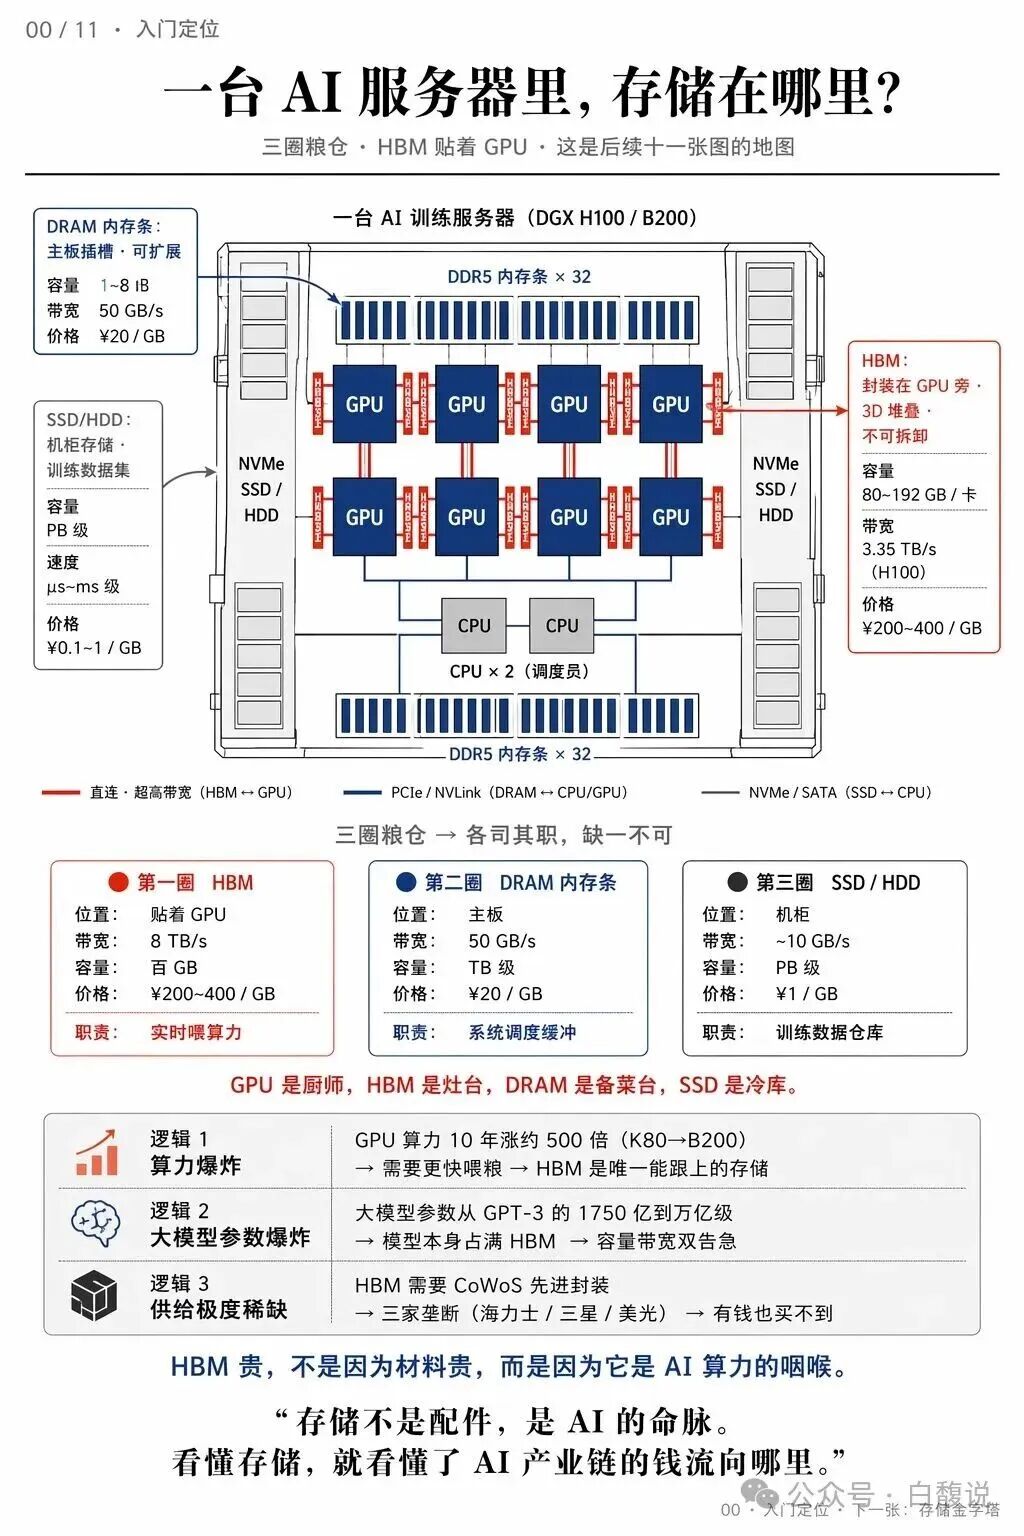
特斯拉将其下一代Dojo 3训练加速器描述为一种基于芯粒的设计,结合了2.5D和3D封装技术以及堆叠HBM。这与最初依赖分布式片上SRAM并通过晶圆级封装技术互连25个带有11GB SRAM的D1处理器的Dojo D1晶圆级系统架构大相径庭。采用HBM表明特斯拉打算大幅增加内存容量,因为现代AI模型需要消耗极大量的内存来存储参数、激活值和中间数据,这使得SRAM在容量方面缺乏吸引力。使用HBM简化了内存扩展,但引入了不同的延迟、带宽、封装和功耗权衡。目前尚不清楚该公司是否已完全放弃晶圆级集成。
一方面,可以将定制的HBM模块堆叠在使用晶圆级封装技术互连的逻辑芯片顶部。另一方面,晶圆级集成成本高昂,且仅对包括以SRAM为中心的架构在内的特定用例最有意义。在晶圆级互连的逻辑芯片上堆叠HBM会增加进一步的设计复杂性、冷却挑战、制造复杂性、长期可靠性问题以及最终的成本。虽然大多数挑战可以通过增加冗余和改进工艺技术来解决,但这都会带来成本,使得D3采用晶圆级扩展的可能性降低。
特斯拉尚未披露D3的计算性能、内存容量、制造工艺或开发时间表。同时,该公司声称其Dojo D3将针对太空、训练和扩展进行优化,这意味着该单元将提供不错的性能并且易于扩展,这再次指向更传统的加速器架构,而非晶圆级封装。更有趣的是,D3还计划针对地外部署进行优化,这可能意味着至少部分产品将具备抗辐射能力。
路线图中的另一个有趣细节是披露了特斯拉第六代推理加速器的大致计算性能:相比第四代硬件计算性能提升80倍,内存增加9倍。根据第四代硬件性能的衡量方式,其算力约为17280至46080 TOPS,或17.28至46.08 POPS,尽管尚不清楚第六代推理加速器支持的数据格式。当然,这些只是估计值,需理性看待。为了将这些数据置于具体背景中,英伟达的Rubin GPU提供50 NVFP4 PFLOPS的推理算力、35 NVFP4 PFLOPS的训练算力以及17.5 FP8/FP6 PFLOPS。目前Rubin正在向客户发货,而第六代推理加速器预计将于2029年至2030年间推出。
特斯拉目前在其汽车中使用的现有第四代推理处理器由三星晶圆厂使用其7纳米级工艺技术制造,并采用传统的倒装芯片球栅阵列封装,以及可能为16GB的GDDR6内存。该公司将该处理器描述为其全自动驾驶技术的当前基准,这也是衡量未来几代产品性能的基线。同时,特斯拉并未正式披露该芯片的绝对计算性能数据、内存容量或功耗,这使得比较变得困难。马斯克曾表示,第四代硬件的性能是第三代的3到8倍,而第三代的官方额定算力为72 TOPS,这使得第四代硬件成为一款算力在216至576 TOPS之间的ASIC。
不出所料,该路线图再次证实,即将推出的第五代推理加速器将分别采用台积电和三星晶圆厂的3纳米和2纳米级工艺技术制造,并将采用多芯片模块设计,这标志着偏离了第四代硬件使用的传统封装方法。特斯拉预计第五代推理加速器将比第四代硬件带来40倍的性能提升,这将是计算能力提高8倍以及硅片优化带来5倍增益的结果。据马斯克称,这指向8640至23040 TOPS的算力。同时,该处理器的功耗预计根据应用在250W到800W之间,因此在此时进行性能估算并不十分准确。此外,该处理器的内存将是其前代产品的六倍,即96GB。根据所使用的内存类型,特斯拉第五代推理加速器可提供768 GB/s至1.536 GB/s的内存带宽。
接着看特斯拉的第六代推理加速器,其计算性能将进一步提升至第四代硬件的80倍,并配备比当前一代处理器多八倍的内存。这可能转化为17.28至46.08 POPS,以及144GB的内存,这对于AI加速器而言是显著的性能和内存容量。
特斯拉已与三星晶圆厂达成协议,将制造其第六代推理加速器直至2033年,新路线图显示该单元将使用2纳米级工艺技术制造。考虑到该芯片预计于2029年至2030年推出,结合三星最近更新的代工路线图,讨论的可能是车规级SF2A、性能增强型SF2P,甚至是带有背面供电的SF2Z。同时,第六代推理加速器引人注目的是,特斯拉并未设想在2030年代使用英特尔的14A制造工艺生产该芯片。
第六代推理加速器将保留在第五代推理加速器中引入的多芯片模块方法,这似乎是合理的,因为它将能够利用从第五代推理加速器中获得的经验,并保持相对合理的封装成本。许多汽车制造商正在考虑在其下一代系统级封装中采用多芯粒设计和HBM内存,这将推高其成本。特斯拉何时在其推理加速器中采用HBM仍有待观察,但在第六代推理加速器上可能不会。
来源: 海外媒体
登录后即可参与技术讨论与同行交流
免费注册