随着模型和硬件效率的提升,AI的使用量可能会不断扩大,正如杰文斯所预测的那样。但硅芯片路线图为这一市场预测增加了一层复杂性。
Gartner与杰文斯悖论
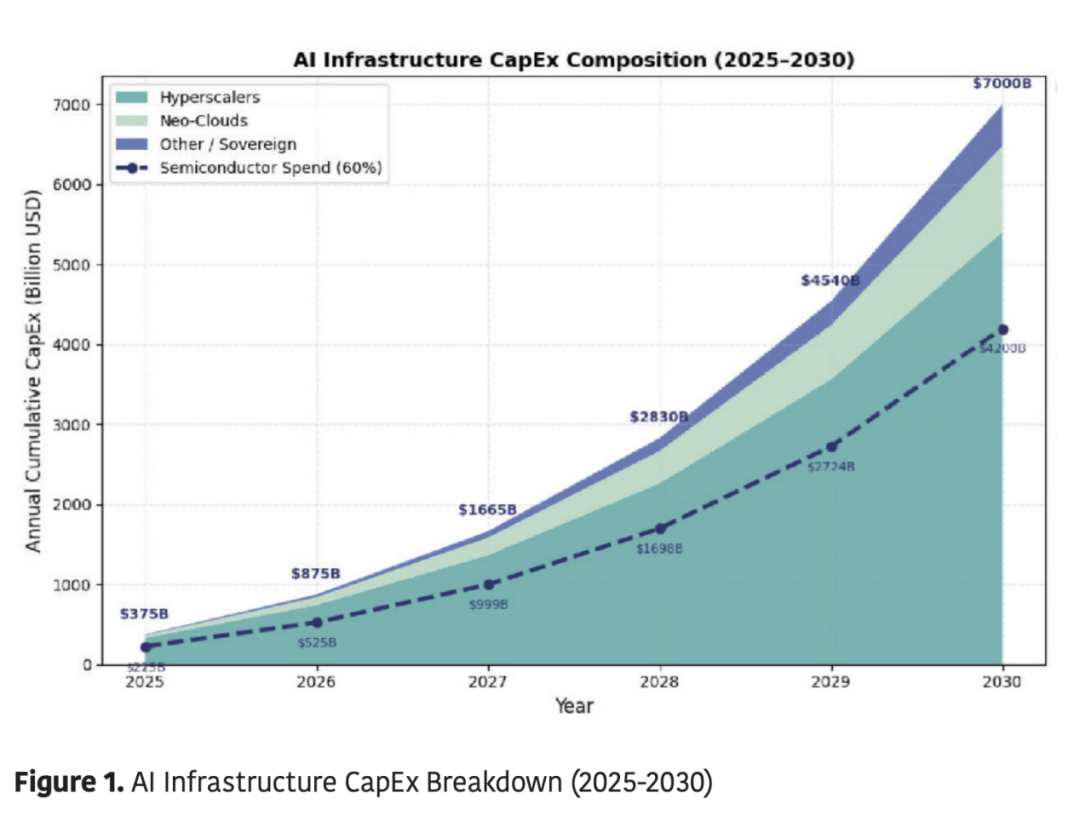
几周前,Gartner发布了一份引发对AI基础设施担忧的预测。AI提供商将在2026年投入近1万亿美元用于基础设施,并在2027年至2030年间再投入6万亿美元。为了支付这些费用、覆盖借贷成本并仍获得12%的回报,AI数据中心的所有者到2030年需要约8.5万亿美元的收入。Gartner预计,实际到达这些数据中心的AI收入最多为3.6万亿美元。Gartner表示,按照这种算法,到2030年,超过3.5万亿美元的支出可能面临减值风险,超过80%的新兴云服务商将不再作为独立公司存在。这是基于Gartner假设下的风险评估,而非预测全部金额都将被注销。
另一方面,笔者认为,这种计算假设AI将继续以与今天类似的方式和商业模式进行部署。然而,我们可能正处于AI使用曲线的起步阶段。根据目前广为人知的杰文斯悖论,一项技术越普及,人们就越能发现该技术的新使用模式,因此,即使技术价格下降,总使用量带来的收入也可能上升。举例来说,当汽车变得更省油时,每公里成本降低,人们会开得更多、行程更远,最终可能会消耗更多的燃料。便宜的汽油也有类似的效果:当价格下降时,人们开车更多;当价格上涨时,一些人会选择公共交通。
回到AI使用量,Epoch AI估计,自2023年以来,在其跟踪的基准测试中,达到特定基准分数的成本每年大约下降13倍,当然对于基准测试的选择通常存在一些保留意见。
因此,根据杰文斯悖论,我们可以预期更便捷的访问和更低的价格将催生新的应用和更高的整体使用量。这应该是长期趋势,尽管没有任何保证需求增长会快于价格下降。
据此,Gartner可能基于当前的使用案例和需求展示了一种悲观的视角,而这些需求在未来几年可能会成倍增长。话虽如此,还有一个额外的复杂因素:与看起来年复一年相同的加油站不同,数据中心(或AI工厂)今年的芯片可能与明年不同,无论是由于不同的世代还是不同的架构。由于这些新芯片需要额外投资,并可能导致之前的投资被注销,这使得Gartner的预测变得更加复杂。
芯片租赁市场释放的信号
到目前为止,“旧芯片”保持价值的时间似乎比预期的要长。最近,a16z发布了一张图表,基于截至10月19日的Ornn租赁数据,比较了英伟达每个主要世代芯片当前的租金与预测价格。预测很简单:取每个芯片观察到的首次租金,并假设其在六年内呈直线下降至零,大致类似于超大规模云服务商在账面上注销这些服务器的方式。由于每条芯片的线都从其自身观察到的首次租金开始,因此各系列在芯片生命周期的不同时间点开始。现在每个世代的租金都高于该预测线:A100高出9%,H100高出54%,B200高出111%,H200高出143%。
还需注意的是,根据a16z的说法,大部分差距是在4月份之后拉开的,当时Token需求激增,这与杰文斯悖论的作用相一致,尽管仅凭图表无法证明其原因。
不过,有两点值得注意。在大部分生命周期中,这些芯片的租金低于那条线,而且租金并不等于利润:在支付了电力、冷却、网络、设施以及借贷成本后,一个芯片即使租金表现良好,其所有者仍可能亏损。
低成本油井与高成本油井
据外媒报道,算力被形容为“新石油”,笔者认为这是一个在不同层面都很有用的比较。Token就是“桶”,是客户实际购买的“东西”。每个GPU世代就是一个油田。有些油井开采容易且成本低,产出的石油质量更好,因此每桶成本很低。另一些则开采困难,产出的原油质量较低,因此每桶成本更高。对于GPU而言,生产Token的成本主要取决于每个世代生产Token所需的能耗,以及它是否能处理这些工作。
当油价高企时,每口油井都在抽油,即使是成本高昂的油井。当价格下跌时,成本最高的油井会最先关闭。芯片的表现也是如此。当需求非常高时(正如4月份以来的情况),即使是A100也被需要,每个世代的租金都高于预测线。这正是a16z图表所显示的。当新一代芯片大量上市时,它就是新的低成本油井;价格下降,最旧的芯片会最先被关停。例如,微软计划从2027年起将其自研的Maia加速器扩展至多吉瓦级部署,声称每兆瓦可多产出40%的Token,这一数据尚未得到独立验证。
并非所有Token都相同
这种石油比较仍然将每桶石油视为相同的,而笔者认为这正是我们迄今为止大多数分析过于简化的地方。Token以及生成它们的芯片并非完全相同。交互式和智能体工作需要低延迟和最新、最快的内存。批量工作(如隔夜处理文档、生成合成数据或运行评估)主要关注成本,几乎不在意延迟。一个已完全折旧的芯片,其剩余成本主要是电力、冷却和维护,可能是生产这些Token最便宜的方式。因此,不存在单一的石油市场,而是存在多个市场,对应每种广泛类型的工作。
然而,这里有一个转折:通常情况下,杰文斯悖论增加的需求本质上是价格敏感的,其用途只有在AI变得廉价后才变得有价值。其中一些将是高价值应用,但许多将是批量工作,这正是旧硅芯片最具竞争力的地方。最近一个有趣的例子是TypeSafe AI推出的Jev,据外媒报道,该模型返回的是结构化决策而非文本,其开发者声称其成本比大语言模型低数百倍。这类模型可以将许多智能体决策从昂贵的大语言模型中转移出来,笔者认为它们非常适合在旧硬件上运行,尽管TypeSafe并未说明其运行平台。
在另一个极端,前沿模型变得越来越大,许多模型越来越稀疏,每个Token只激活模型的一小部分,如混合专家(MoE)模型。对于其中最大的模型,瓶颈可能不是原始算力,而是内存容量和芯片之间的快速连接,这使得机架(而非芯片)成为前沿计算的基本单位。对于这类模型,旧GPU的问题不在于太慢,而在于太小且太孤立。也许会出现能更好地应对这些模型稀疏性的新架构。
除了这两个极端,还有其他类型的模型——从推荐引擎到图像生成再到科学模型——并非所有模型都需要相同类型的硬件。
综合来看,这在我看来像一个哑铃。巨型模型倾向于最新的机架级系统,而小型和专用模型则在旧硅芯片上运行良好。我的假设是,受挤压的是中间部分:既非最前沿也尚未完全折旧、仍在账面上保持高价值的芯片。如果我是正确的,2024年和2025年的大量支出正坐落在这个区间。
异构数据中心
这里还有另一层复杂性:过去,数据中心总是混合使用不同的硬件,但种类通常适中。十年前的云数据中心运行不同类型的CPU、内存、存储和网络,其工作是将工作负载匹配到相当可预测的菜单中。这些服务器也能优雅地老化。每一代新CPU只比上一代好一点点,因此旧服务器能持续盈利数年,有点像租赁汽车,去年的车型几乎和今年的一样好。
如今,菜单要丰富得多。CPU旁边是GPU、TPU和其他AI加速器,推理正越来越多地被拆分到在不同芯片上运行最佳的各个阶段。英伟达在2025年宣布了用于预填充阶段的专用芯片Rubin CPX,随后据外媒报道,为了基于从Groq授权的技术、专注于解码的机架,将其搁置,可能推迟到后续世代。加上通常仍需要高精度数学运算(许多AI芯片将其优先级降低)的高性能计算(HPC),将每个工作负载匹配到合适硅芯片的工作变得更加困难,每一代硅芯片的老化速度也更快。
最大的运营商能够负担得起这种多样性。凭借足够的规模,他们可以让多种硬件保持忙碌,并将每项任务路由到能完成该任务的最便宜芯片上。较小的数据中心则做不到这一点,对他们来说,通用GPU仍是最安全的选择,因为它可以随着老化从训练过渡到推理再到批量工作。专用部件每项任务的成本更低,但作为资产更脆弱,因为它们失去了开启第二和第三职业的能力。
专用的本地安装则是另一种情况。运行自己熟悉的工作负载的公司可以选择紧密匹配的配置,而不需要追逐每一代新产品。对于这类工作负载,最先进的硅芯片主要用于训练定制模型,或许还有少数GPU加速的求解器。
硅芯片路线图时间表
阅读全文,请访问:https://www.eetimes.com/jevon-paradox-and-the-silicon-roadmap/
来源: 海外媒体

登录后即可参与技术讨论与同行交流
免费注册