关键要点:RISC-V在AI中的作用存在争议。它的定制化能力提供了灵活性,但将推理工作负载在CPU与加速器之间拆分,可能引入昂贵的数据搬移和编译器复杂性。控制可能是RISC-V的最佳选择。自定义指令可以帮助协调加速器、降低加载/存储延迟,并处理有限的数学任务,而不承担繁重的推理任务。正确的指令并不能保证一颗可用的芯片。自定义AI系统还需要可观测性和系统级验证,以暴露性能瓶颈、缓存一致性问题和互连死锁。
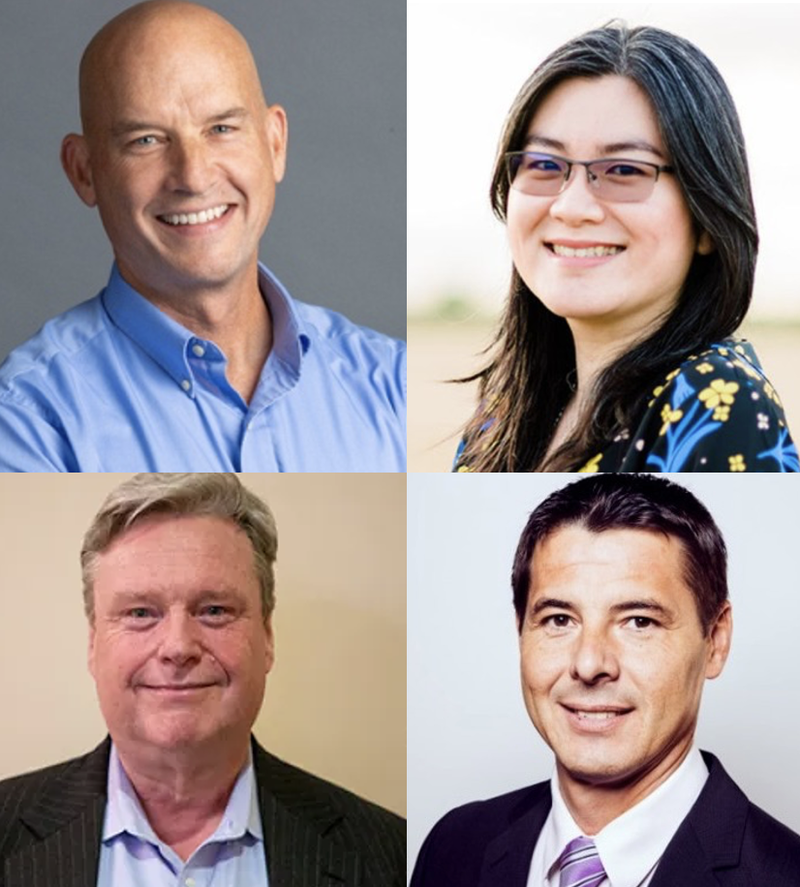
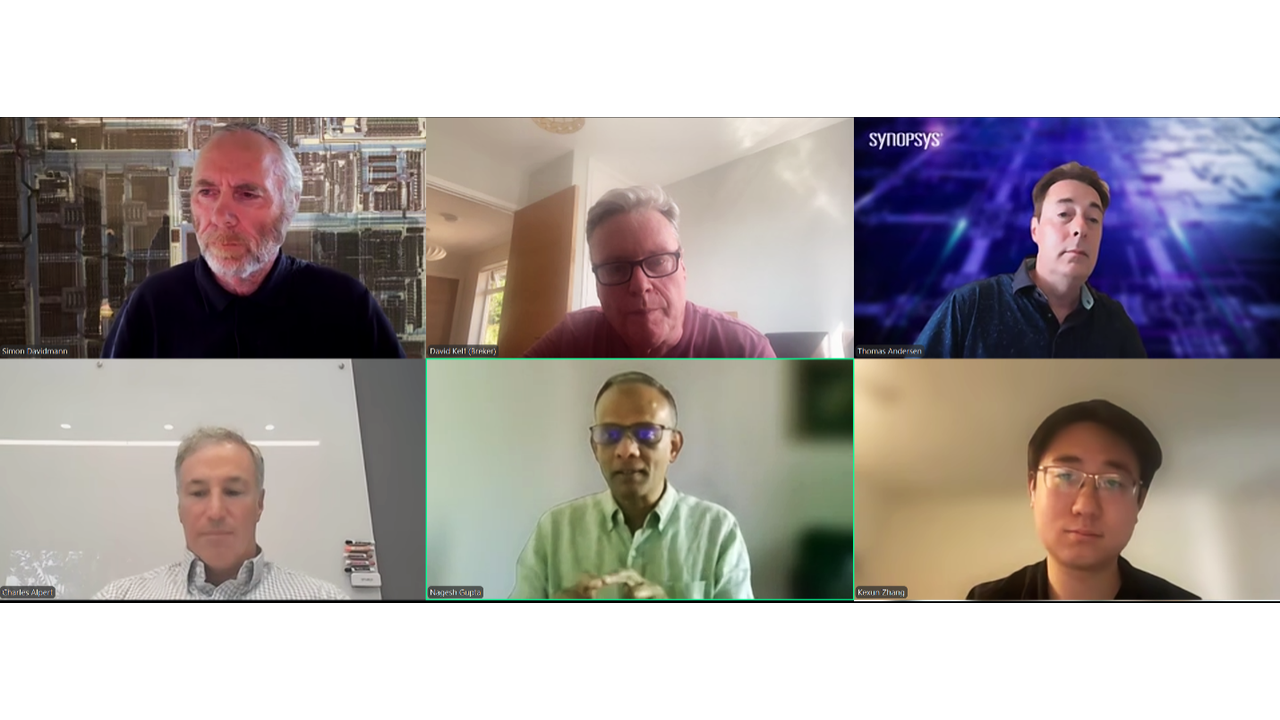
桌边专家:对并行度和能效的需求正在推动芯片设计从通用计算转向AI,并增加了对灵活、模块化和开放硬件的需求。这一趋势正在把RISC-V带入AI加速。可定制硬件可以直接实现AI计算,而不必依赖固定CPU设计。一家海外媒体与Quadric首席营销官Steve Roddy、西门子EDA Tessent产品管理与产品工程总监Francisca Tan、SignatureIP销售与业务发展高级副总裁Ewald Liess,以及Breker首席执行官Dave Kelf坐下来讨论了这些问题。以下为该次对话的摘录。
从左至右:Quadric的Roddy;西门子EDA的Tan;SignatureIP的Liess;Breker的Kelf。
问:随着AI模型快速演进,架构师们正在使用RISC-V设计高度专用化扩展。从IP供应商的角度看,如何在交付标准化、可复用IP核与满足客户对AI工作负载极端定制化需求之间取得平衡?
Liess:我们认为我们不需要进行配置,因为我们提供NoC、PCI Express、CXL CHI AMBA接口。基于这一点,我们不需要定制。相反,将被配置的是NoC。由于我们拥有预验证的NoC,我们可以用自己的工具完成这一点。我们可以配置定制化RISC-V。当然,客户可能会用新指令修改RISC-V核心,但他们会继续使用AMBA总线、CXL、PCI Express等接口,因为这使他们能够访问所需的外部组件,例如存储器或片外连接。这正是我们发挥作用的地方。因此,RISC-V方面可以随意做他们想做的事。
Tan:定制化验证和确认也变得重要,可观测性同样如此。对于测试和嵌入式分析,进行调试或芯片启动的工程师可以监控、内省和检查内部信号,或计算性能是否达标。我认为,随着行业进入芯片中的各种挑战和复杂性,这也关乎硬件可观测性。
Roddy:在这个特定领域,我们持相反观点。我们认为,从RISC-V出发做AI加速器完全是一个坏主意,因为你立刻制造了一个问题。现在你有了一个划分:一些东西运行在具有良好ALU能力的可编程处理器上,另一些东西在外部加速器上,而你必须对系统进行划分。一旦划分,一旦制造问题,你就需要复杂的编译器来修复它,弄清楚如何在加速器之间通过良好的NoC把数据搬到可编程核心,并来回搬移。这个问题扩展性很差。加速器越大,情况越糟。于是问题被进一步放大。假设你有大约100 TOPS,并且必须让大约16个RISC-V处理器从属于一大堆加速器模块,那么当然,你需要出色的互连,也需要出色的验证,以及所有配套条件,因为你试图解决的根本问题是:从CPU出发。CPU擅长追逐指针,这就是CPU的工作。CPU拥有出色的逻辑,可以处理你有40个线程在运行、而下一个时钟节拍完全不知道会运行什么的情况。但进行AI推理时并不是这样。你提前数百万个周期就知道会发生什么。你不需要大部分CPU硬件。DSP稍微接近你需要的东西,但DSP是向量机器,即向量乘标量或向量乘向量。而AI中最具挑战性的部分大多是矩阵乘矩阵。因此我们构建了一台矩阵原生机器。我知道唯一接近这一点的另一种方案位于数据中心,也就是谷歌的大型TPU。可以说,其他所有人都面对一个被划分的问题,然后他们挣扎着投入数十亿美元,试图处理这个划分问题,并弥补他们从一个我们认为糟糕的起点出发这一事实。
Kelf:我同意Steve的观点,因为我们看到大型AI加速器已经相当普遍,它们可能采用不同架构,例如SIMD、SIMT。这些东西基本上由某种复杂状态机控制,或者一直由复杂状态机控制,然后会有某种主机处理器驱动这些不同的部件,并告诉状态机该做什么,然后驱动加速器。我们在四个案例中看到,无论是大公司还是小公司,这些状态机都无法胜任。于是他们采用RISC-V处理器,将其用作这些加速器之上的控制功能,原因有很多。首先,他们实际上可以内置一堆数学引擎,正是Steve提到的那些,向量类型,使用RISC-V向量指令或类似指令。然后他们还会加入自己的指令,或者一些新的矩阵乘法指令。他们还加入自己的指令,以实现非常高效的加载/存储,降低你在划分之间看到的延迟。因此他们正在想办法调整这些RISC-V处理器,以降低延迟并减少划分问题。我们有一些例子,其中一些成功,一些不那么成功。他们仍在解决这个问题,但RISC-V的好处在于,他们可以添加任何想要的自定义指令,仍然使用常规编译器,并创建一种机制来驱动非常高效的加载/存储,而这是其他处理器做不到的。当然,也有安谋等公司把指令内置到部分处理器中,但它们不是可变的。RISC-V非常适合这一点,并且在创建这些强大自定义指令的能力方面相当独特。
问:关于那些自定义向量指令,EDA工具是否正在考虑这一点,并自动化验证?
Roddy:我在Tensilica工作了17年。我们把所有这些都自动化了。当然,缺点是你要支付版税。RISC-V提供了一个机会,不必向大公司支付版税、贡金或税费。如果你想要定制化,Tensilica的团队多年前就实现了自动化。其理念是改变指令,并立即获得与之匹配的编译器和仿真器,验证也能得到处理,因为它处在结构化环境中。RISC-V提供了一些灵活性,可以超出这些边界。我的看法是,如果你真的想使用RISC-V,最好全力以赴地进行定制,付出努力手工创建所有这些东西;因为如果你只想要一点点定制,我在Tensilica的老朋友们有一套自动化系统可以实现这一点。是的,它有商业成本。RISC-V是一项非常有趣的技术,它绝对有其用途。市场领导者不允许在控制和CPU功能上达到这种灵活性。针对手头的控制功能调整和调优处理器,可以获得很多价值。我们只是认为在它上面做推理没有意义。但CPU有数千种用途,RISC-V CPU做这些事情可能更灵活、更高效,而且肯定比其他供应商的固定功能CPU价格更低。我们只是认为,把繁重计算和推理作为部署这种技术的正确方式并不合适。
Kelf:我倾向于同意。一些公司正试图内置向量,并构建自己的数学类DSP型指令。我和一些遇到问题的客户交谈过。他们有一个SIMT阵列,即单指令多线程,并进行大量并行数学运算,希望其中一个并行通道不会偏离其他通道。然后其中一个偏离了。SIMT的好处是你可以让它偏离。他们使用RISC-V控制处理器来处理偏离产生的一部分数学运算,让加速器的其余部分继续处理其余数学运算。他们并没有在RISC-V内部做繁重处理,只是做足够让整个机器工作并降低延迟的事情,但这是在RISC-V内部做一件奇怪的事情。他们花了大量工作才让它正常运行,但现在他们认为这相当成功。我同意RISC-V的商业一面,即你不必支付版税;我也同意Tensilica技术,它非常适合这类事情,尤其是DSP通信。但他们可以在RISC-V内部做类似事情。他们必须自己构建,必须知道如何构建。但一旦做到,就会有很多灵活性,围绕RISC-V也有很多标准化。他们可以获得编译器,也可能转向另一家公司,并把一些专有内容构建到那个RISC-V中。这确实带来更多灵活性,也带来更多标准化,而固定处理器和专有处理器可能无法提供这些。
Tan:就测试和更好的分析为自定义指令提供什么而言,尤其是在RISC-V领域,我们支持自定义指令跟踪的可调试性。我们支持RISC-V用户指定他们希望在处理器运行时跟踪哪些自定义指令,以支持该可调试性环境。我们也是RISC-V组织的成员之一,几年前我们捐赠了高效跟踪(E-Trace)规范。这是一种高度压缩的指令跟踪,面向将有大量数据的复杂系统,因此我们也需要考虑压缩所有这些数据。在我们的基础设施中,不仅仅是处理器,而是整个系统。因此,我们的基础设施可以从RISC-V核心以及RISC-V SoC的各个部分捕获指令跟踪,例如互连、总线监控,或我们希望监控的特定信号。
阅读全文,请访问:https://semiengineering.com/risc-v-for-ai-breakthrough-or-bad-idea/
来源: 海外媒体


登录后即可参与技术讨论与同行交流
免费注册