论文解读:本文介绍了由英伟达、Arm和英特尔联合提出的FP8(8位浮点)格式研究成果。该研究提出了一种包含E4M3和E5M2两种编码的FP8二进制交换格式,旨在加速深度学习训练和推理。实验表明,在多种图像和语言任务中,FP8格式能够有效匹配16位训练的结果质量,为大型语言模型等现代神经网络架构提供了高效的低精度计算方案。
业界正从高精度格式(FP32、FP16、BF16)转向用于机器学习推理和训练的低精度数据类型。在云和数据中心环境中,低精度数据类型通过在相同平台上每个周期封装更多计算来提供更高的吞吐量。在边缘和移动设备上,较小的格式可减小模型大小、内存占用和带宽,从而直接影响功耗和延迟。
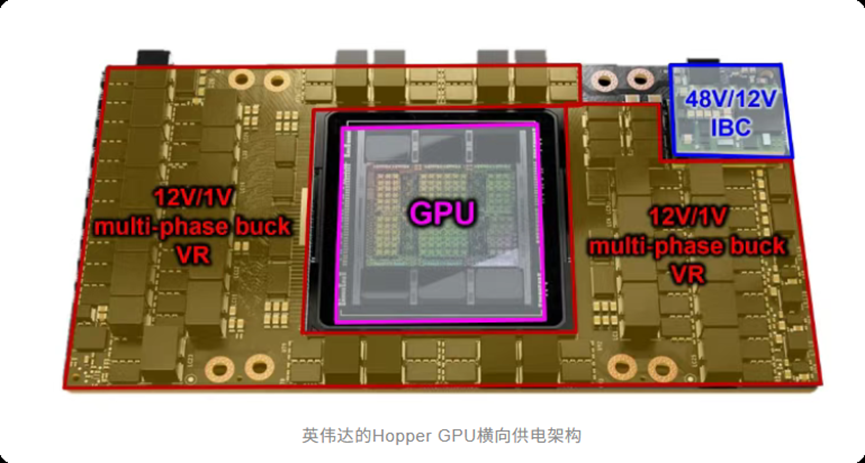
Arm、英特尔和英伟达发布了OCP 8位浮点规范。这是一种交换格式,允许软件系统轻松共享模型。FP8并非未来概念,而是正在部署中。它已得到英伟达Hopper H100 GPU的支持,软件部署也出现在主要的机器学习框架中。
Arm在Arm v9指令集架构中增加了FP8支持,并正在探索在所有机器学习平台上集成FP8的最佳方式。
这篇博客文章解释了FP8数据格式、新的浮点模式寄存器,以及使FP8在Arm CPU上变得实用的指令集。
FP8数据格式
与IEEE FP64、FP32和FP16不同,FP8不是单一格式,而是一个系列。白皮书《深度学习的FP8格式》提出了一种由两种编码组成的FP8格式:E4M3和E5M2。
为什么是一个格式系列?
由于只有8位可用,FP8在精度和动态范围之间做出了权衡。单一编码无法同等地适应所有张量。激活和权重在训练或校准后通常具有更小且更稳定的值分布。因此,它们可以从更多的尾数位中受益,这有助于更精确地表示相邻的值。梯度在前向和反向传播过程中可能会发生更大的变化。因此,它们可以从更多的指数位和更大的动态范围中受益,这有助于避免溢出或下溢。
这两种编码使软件能够为每个张量角色选择合适的格式。当精度更重要时使用E4M3,当动态范围更重要时使用E5M2。这是FP8的关键理念,Arm在浮点模式寄存器中也反映了相同的理念。借助该寄存器,每个源操作数可以独立选择其使用的FP8格式。
在支持的数据类型方面,E4M3使用1个符号位、4个指数位和3个尾数位,偏置为7,最大正常值为448,仅支持NaN特殊值。E5M2使用1个符号位、5个指数位和2个尾数位,偏置为15,最大正常值为57344,支持Inf和NaN特殊值。
E4M3使用1个符号位、4个指数位和3个尾数位,偏置为7。E4M3将大多数位模式用于正常有限数,而不是为特殊值保留许多位模式。这有助于E4M3扩展动态范围,这对深度学习工作负载更有用。
E5M2使用1个符号位、5个指数位和2个尾数位,偏置为15。E5M2遵循IEEE 754关于指数域和特殊值的约定,包括无穷大和NaN。因此,它可以被视为具有较少尾数位的IEEE FP16,就像bfloat16和TF32可以被视为具有较少位数的IEEE FP32一样。这使得E5M2和IEEE FP16之间的转换变得简单,同时仍提供比E4M3更宽的动态范围。
浮点模式寄存器
当硬件执行FP8指令时,它必须知道每个源操作数的格式、目标结果的格式以及要应用的缩放因子。
由于FP8模式可以按张量更改,软件可能需要在性能关键代码中频繁更新格式和缩放设置。因此,Arm引入了一个专用控制寄存器——浮点模式寄存器。该寄存器独立于浮点控制寄存器。硬件可以更高效地识别和重命名写入操作,使每个张量的FP8模式更改更接近于普通寄存器写入,而不是流水线序列化的控制更新。
该寄存器包含多个字段。F8S1字段表示第一个FP8源的格式,0b000代表E5M2,0b001代表E4M3。F8S2字段表示第二个FP8源的格式,编码与F8S1相同。F8D字段用于将其他浮点格式转换为FP8的指令的目标结果格式,编码与F8S1相同。OSM字段用于FP8乘法指令的溢出饱和。OSC字段用于FP8转换指令的溢出饱和。LSCALE字段是无符号Log2向下缩放因子,计算方式为目标结果乘以2的负LSCALE次方。NSCALE字段是用于加宽FP8源的无符号Log2向上缩放因子。LSCALE2字段是用于双源转换指令的第二个向下缩放值。
Arm上的FP8指令集
2023年和2024年的架构扩展在Advanced SIMD、SVE和SME中添加了FP8指令。
在架构特性方面,FEAT_FP8在Advanced SIMD、SVE和SME中支持FCVTN、FCVT、F1CVT、F2CVT、BF1CVT、BF2CVT和FSCALE等FP8转换指令及浮点缩放指令。FEAT_FP8FMA在Advanced SIMD和SVE中支持FMLALB、FMLALT等FP8加宽乘加指令。FEAT_FP8DOT4和FEAT_FP8DOT2分别在Advanced SIMD和SVE中支持FDOT指令,实现FP8到FP32的4路点积以及FP8到FP16的2路点积。FEAT_SSVE_FP8FMA、FEAT_SSVE_FP8DOT4和FEAT_SSVE_FP8DOT2在SME的Streaming SVE模式下支持相应的FP8加宽乘加、4路点积和2路点积及累加指令。FEAT_SME_F8F32和FEAT_SME_F8F16在SME中支持FP8外积和点积并累加到FP32或FP16的ZA阵列中。FEAT_F8F32MM和FEAT_F8F16MM在Advanced SIMD和SVE中支持FMMLA指令,实现FP8到FP32或FP16的矩阵乘加。
所有FP8计算指令从浮点模式寄存器读取源格式,并通过缩放字段应用缩放。这些加宽指令始终使用FP8数据作为输入格式。累加使用更宽的类型,如FP16或FP32。这保持了FP8输入的带宽优势,同时在累加过程中保持了数值稳定性。
进一步阅读
有关FP8的更多详细信息,请参阅A-profile架构的Arm架构参考手册和《深度学习的FP8格式》论文。
第二部分将探讨FP8指令,从Advanced SIMD、SVE和SME中的转换和缩放到点积、矩阵乘法和外积。
阅读全文,请访问:https://arxiv.org/abs/2209.05433
来源: 海外媒体
登录后即可参与技术讨论与同行交流
免费注册