当大模型塞进MCU,AIoT的算力密度谁定义?
当GPT-4级别的能力被压缩进几十MB的端侧存储,当百亿参数大模型在Cortex-M系列MCU上实现实时推理,当TinyML从"玩具Demo"变成"量产标配"——端侧AI不再是未来概念,而是当下每个硬件工程师必须面对的选型现实。 更紧迫的是"算力密度"的军备竞赛。联发科把端侧智能体能力做成可部署的工程体系,意法半导体的STM32N6加持AI手势识别并实时控制灵巧手,芯片厂商正在重新
「算力密度」是电子工程与展会、芯片新品领域的重要技术专题。纳米网为您深度聚合了 3 篇关于 算力密度 的硬件电路设计方案、芯片选型参数对比、产业动态研判与原厂参考资料(最近更新于 2026年06月)。核心收录议题涵盖《当大模型塞进MCU,AIoT的算力密度谁定义?》《Tech Talk热点Q&A汇总 | “周易”X3 NPU IP R2新版本》《Tech Talk回顾丨“周易”X3 NPU R2版本升级,最高算力翻倍+算力密度跃升!》等实战工程解析。工程师可结合站内芯片选型库与 Datasheet 资料库进行一站式方案验证。
当GPT-4级别的能力被压缩进几十MB的端侧存储,当百亿参数大模型在Cortex-M系列MCU上实现实时推理,当TinyML从"玩具Demo"变成"量产标配"——端侧AI不再是未来概念,而是当下每个硬件工程师必须面对的选型现实。 更紧迫的是"算力密度"的军备竞赛。联发科把端侧智能体能力做成可部署的工程体系,意法半导体的STM32N6加持AI手势识别并实时控制灵巧手,芯片厂商正在重新
Q1 “周易”X3 R2 NPU IP支持FP4且算力翻倍,主要是满足什么样的需求? A 1.在W4A8和W4A16两种主流大模型量化精度下,单Cluster算力从80 TFLOPS跃升至160 TFLOPS,且支持灵活配置,算力密度提升超70%,能够让客户在相同芯片面积下获得更强的AI性能; 2.边端侧推理正从W4A16向W4A8演进,FP4数据格式的支持正是为未来FP4权重模型的出现做好前瞻准
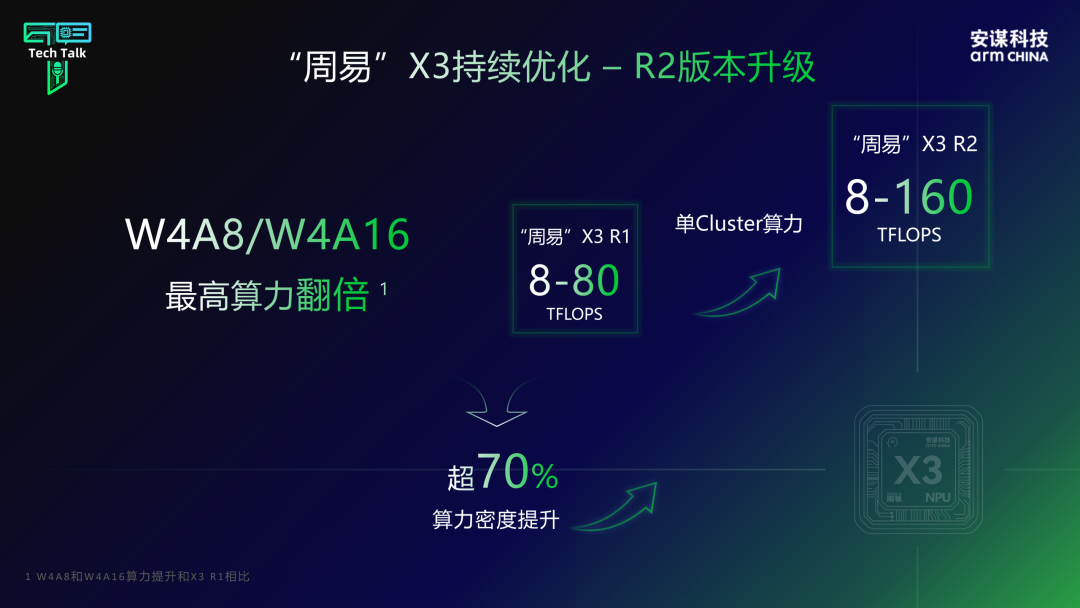
安谋科技Tech Talk AI技术开放麦第二期,NPU高级产品经理Benjamin Ye分享了“周易”X3 NPU IP R2版本升级亮点,详解该版本在算力、算力密度方面的提升,以及“周易”X3系列NPU在智能座舱、AI推理加速芯片及新兴市场等多领域的落地案例。 “周易”X3 R2版本升级 最高算力翻倍、算力密度提升超70% 当前,AI大模型加速从云端向边端侧迁移,对边端侧NPU的算力和效率提出