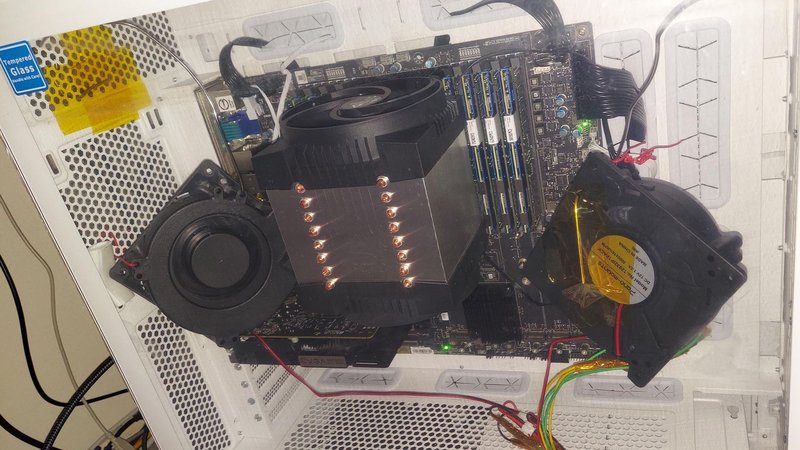
一位家庭实验室爱好者在网络社区发帖称,他使用已停产的第二代英特尔傲腾持久内存 200(Optane PMem 200),在不使用 GPU 的情况下,仅用一颗 40 核第三代至强可扩展处理器运行了一款 2.8 万亿参数 AI 模型。该装置运行温度较高,发帖者建议必须对内存条进行主动散热,并用两个 12W 鼓风机风扇对准内存模组,以控制温度。该项目是今年早些时候另一位用户使用第一代傲腾内存搭建装置的后续,即使在 1-bit 量化下,运行速度也仅为每秒 0.85 个 token,较为缓慢。
第二代傲腾持久内存服务器仅用 CPU 运行 2.8 万亿参数模型,并附带可能保护内存的关键散热警告。
从评估来看,这款 2.8 万亿参数模型并非面向家庭使用而设计;模型官方建议使用数据中心推理引擎运行,即便是社区最小的量化版本,也至少需要 610GB 内存。相比之下,使用二手傲腾内存是少数能够在家中达到这一容量的方式之一。与此同时,DRAM 价格大幅上涨,发帖者称傲腾内存的成本仅为同等容量常规内存的一小部分。
英特尔在 2020 年面向第三代至强可扩展处理器推出了傲腾持久内存 200 系列(PMem 200),容量包括 128GB、256GB 和 512GB。在双路至强平台上,其有效 MT/s 速率高于第一个项目使用的第一代产品(PMem 100),平均内存带宽最多可提升 32%。傲腾可以运行在内存模式或 App Direct 模式;上述两个装置的平台都支持这两种模式。
内存模式由傲腾充当系统内存,DRAM 作为其缓存,这是第一个装置使用的方式;App Direct 模式则将傲腾作为一个独立的持久化区域暴露出来,由软件直接映射,第二个装置使用的是这种模式。第一个装置的创建者表示,这样可以更好地控制模型张量存放的位置,并计划尝试该方式。
与 DRAM 相比,选择傲腾会带来性能损失;在采用更高的 3-bit 量化后,速度进一步下降至每秒 0.75 个 token。一位评论者指出,这一速度非常慢,按每秒约 1 个 token 估算,5 万个 token 的任务大约需要 13 小时;但另一位评论者表示,夜间批处理任务对速度并不那么敏感。这两个速度均低于第一个装置约每秒 4 个 token 的表现,不过第一个装置除了使用内存模式外,还使用 RTX 3060 处理模型的一部分,并采用 2-bit 量化,且运行的是更小的早期 1 万亿参数模型。
最新这位使用者还必须应对发热问题。在持续推理过程中,傲腾内存条会变得非常热,发帖者称这种情况可能危及相邻 DRAM。这一发热情况与英特尔自身规格一致,因为该公司规定这些模组需要每秒 2.4 至 2.7 米的强制气流进行散热,这通常是数据中心才具备的条件。一般情况下,普通用户不太会让如此强度的气流直接吹向内存条。
在预期工作条件下,每个傲腾模组功耗为 12W 或 15W,与容量无关。如果该装置使用四条内存,就意味着系统内存旁边会产生最高 60W 的热量。这些模组在 83 摄氏度时会降频,在 85 摄氏度时会触发过热保护关机;相比之下,典型 DDR4 服务器内存的额定工作温度为 85 摄氏度,扩展范围最高可达 95 摄氏度。要使系统持续运行,必须从系统中带走大量热量。
文中给出的性能数据是调优前的结果,即尚未调整线程数量或 NUMA 亲和性,因此仍有提升空间。一位评论者还询问,是否可以利用内存模式,通过 DRAM 缓存最常用的专家模块。发帖者计划增加 GPU,并将模型的一部分加载到 DRAM 中,作为与傲腾并行的更快存储层级,后续还将公布更多基准测试结果。
来源: 海外媒体


登录后即可参与技术讨论与同行交流
免费注册