如今,让大语言模型在边缘平台上运行已经相对容易。借助 llama.cpp 等开源框架,用户可以在几分钟内下载模型、运行推理并展示结果。
而优化这一部署,才是真正工作的开始。
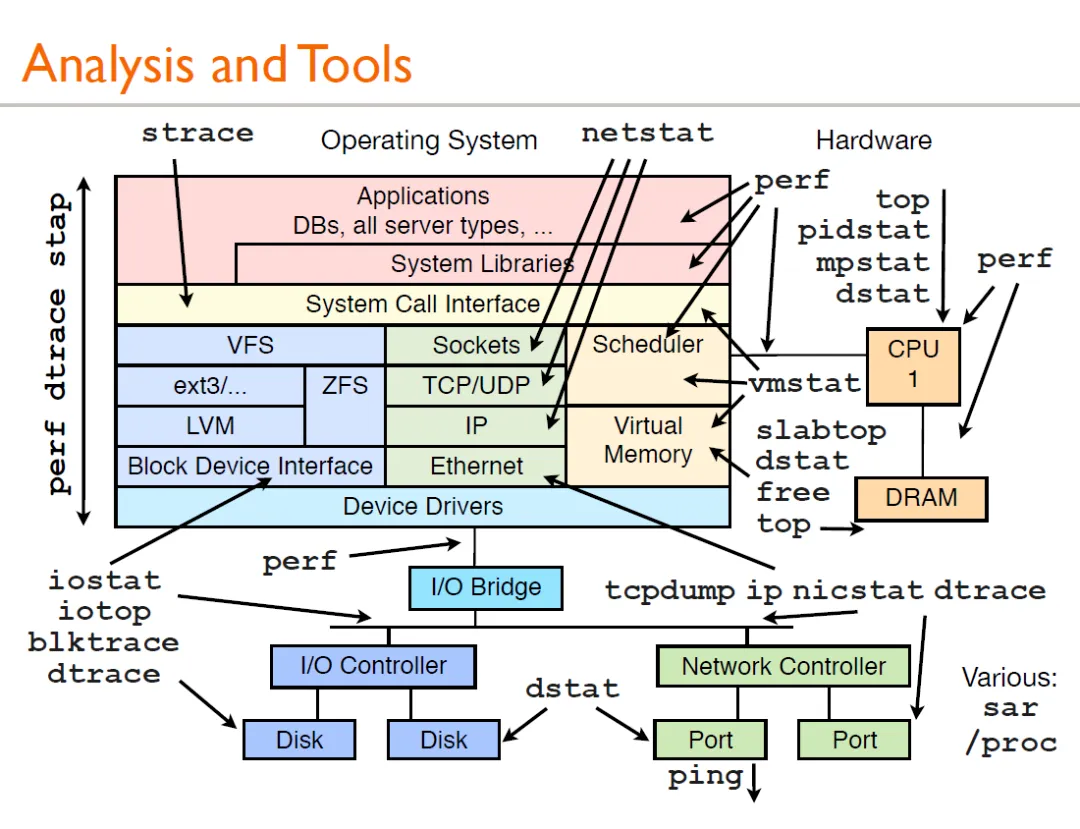
一个模型可能能够正确运行,但吞吐量仍令人失望,内存占用高于预期,或仍有大量性能未被释放。要理解原因,不能只看基准测试数字,还需要考察工作负载如何与底层硬件和软件栈交互。
问题会很快浮现。GPU加速是否得到有效利用?采用不同的量化格式,是否能在精度、内存占用和性能之间取得更好平衡?工作负载的哪些部分最能从GPU执行中受益,瓶颈又在哪里?
随着AI工作负载走向边缘设备,这些挑战正变得越来越重要。与数据中心相比,边缘设备在内存、功耗和成本方面的限制要严格得多。
在11月11日即将举行的一场网络研讨会上,Imagination Technologies的一位工程总监将通过实际示例,讲解如何在边缘GPU平台上移植、分析和优化AI模型。借助真实工作负载和开源软件,我们将审视从可运行演示迈向更高效实现所需的步骤,内容涵盖模型量化、GPU卸载策略和性能分析。
本场活动面向软件开发者、AI工程师和系统架构师,旨在帮助他们更好地了解现代AI工作负载在边缘硬件上的表现,以及如何提升性能。
如果你正在从事边缘AI开发,并希望不仅了解模型能否运行,还了解其性能表现为何如此,这场网络研讨会值得关注。
立即注册。
来源: 海外媒体

登录后即可参与技术讨论与同行交流
免费注册