硅片热氧化工艺的分类和原理
本文介绍了硅片的热氧工艺与退火。 为什么要给硅片“氧化”? 纯硅本身并不绝缘。要让电流在该走的时候走、不该走的时候停,必须在特定区域形成绝缘层。二氧化硅恰好是完美的天然选择:它与硅的晶格匹配良好、击穿强度高、化学性质稳定。氧化层在芯片中扮演三种角色: 栅介质:MOS晶体管中控制沟道开闭的核心绝缘层,厚度可薄至1-2纳米(仅几层原子)。 隔离层:像“围墙”一样隔开不同器件,防止电流串扰,典型
纳米网半导体频道 — 提供半导体领域最新资讯、技术文章和行业动态。
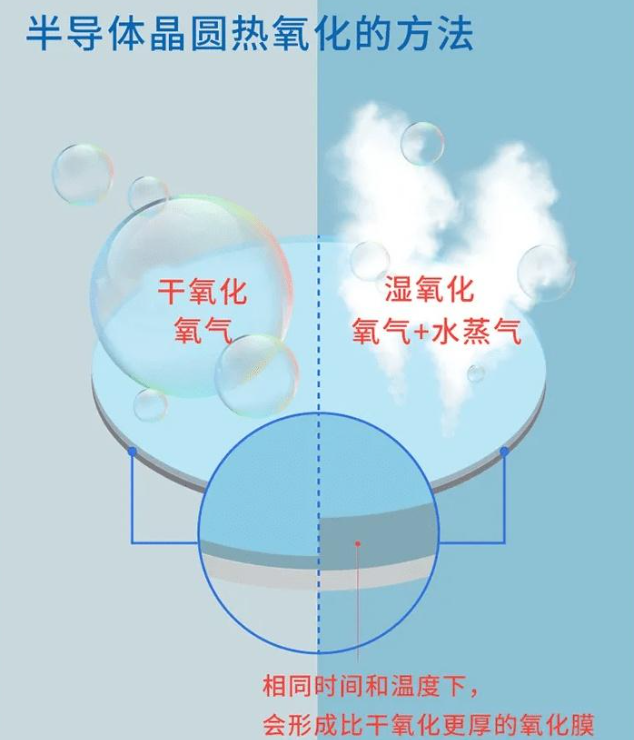
本文介绍了硅片的热氧工艺与退火。 为什么要给硅片“氧化”? 纯硅本身并不绝缘。要让电流在该走的时候走、不该走的时候停,必须在特定区域形成绝缘层。二氧化硅恰好是完美的天然选择:它与硅的晶格匹配良好、击穿强度高、化学性质稳定。氧化层在芯片中扮演三种角色: 栅介质:MOS晶体管中控制沟道开闭的核心绝缘层,厚度可薄至1-2纳米(仅几层原子)。 隔离层:像“围墙”一样隔开不同器件,防止电流串扰,典型
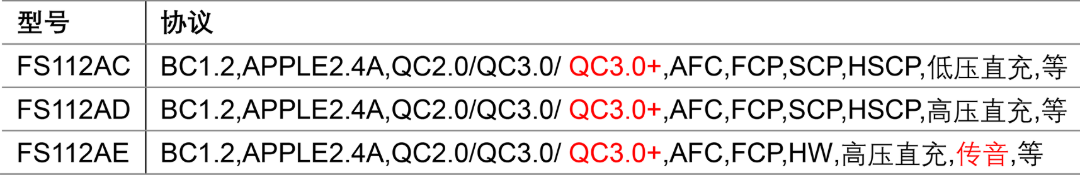
速芯微电子全新升级款FS112A,作为 FS112K 系列实力迭代新品,重新拉高了 TypeA 口快充协议芯片的性价比水准。它在原有协议基础上全面扩容,同时耐压规格升级、外围电路优化,兼容性更强,稳定性更高! 核心亮点 ✅1. 协议丰富兼容性强 支持QC3.0+/QC2.0、AFC、FCP、SCP、Apple 2.4A、BC1.2、高压/低压直充等主流协议; 不同型号(FS112AC / AD /
AI算力的边界在哪里?过去两年,AI大模型的军备竞赛让全球科技巨头疯狂抢购GPU。然而,英伟达CEO黄仁勋却不止一次指出:“未来十年,算力的天花板将由光传输效率决定。”这句话道出了一个被市场长期忽略的真相——即便你手握百万张GPU,如果数据在它们之间的流转速度跟不上,庞大的算力集群不过是一堆昂贵的电子砖头。AI基础设施的内部革命,正悄然转向一个更底层、更隐秘的战场。在这个战场上,一种名为磷化铟(I
Q1 基于“玲珑”峨眉VPU IP可以实现单独编码器或单独解码器吗? A 可以,“玲珑”峨眉是编解码合一架构,可配置为纯编码、纯解码、编解码合一三种形态,纯编码或纯解码形态面积更小。 Q2 基于“玲珑”峨眉VPU IP实现不同配置,交付时间是多久? A 通常情况下,不同配置的“玲珑”峨眉VPU IP可以2周内给到初始版本,1个月内完成最终交付,能够满足芯片开发的进度需求。 Q3 AI高清视频场景下
5月7日,2026新紫光集团创新峰会在北京隆重举行。峰会以“智链共生·聚创未来”为主题,锚定聚焦智能科技产业,推动“协同共赢+突破创新”核心战略,明确三大支柱领域与三大赋能举措,为新紫光集团高质量发展指明方向。作为集团旗下核心企业,紫光展锐紧随战略步伐,深耕端边AI赛道,发布多款端边AI产品和解决方案,携手全球伙伴共筑端侧AI终端新生态。 战略定力:新紫光集团聚焦智能科技产业 推动“协同共赢+突破
新品速递 TJA1410和TJF1410是符合10BASE-T1S规范的物理介质相关 (PMD) 收发器, 丰富了恩智浦的多节点以太网网络产品组合。这些器件专为在严苛环境确保卓越电磁兼容 (EMC) 性能而设计,支持通过以太网数据线,基于3引脚Open Alliance (OA) TC14-TC10远程唤醒标准接口实现通信。 TJA1410按照ISO 26262 ASIL B功能安全等级设计,满
i.MX 937片上系统 (SoC) 在可靠且可扩展的平台上平衡了高性能边缘AI与成本及功耗优化的设计。 边缘计算设计人员长期面临两难抉择:要么选择性能不足的入门级芯片,要么采用价格高昂的高端处理器。由于中间方案的缺失,无论是向上扩展还是向下简化设计,都变得困难重重且代价不菲。随着设计方案的变更与产品线的拓展,工程师亟需具备充分灵活性与可扩展性的微处理器 (MPU) 产品系列,以满足其持续发展的
瑞芯微正式推出面向中阶AIoT市场的RK3572八核处理器,在高性能、低功耗与全栈AI能力之间实现突破性平衡,为广泛应用场景如消费类电子及智能硬件提供极具市场竞争力的算力底座。 RK3572采用8nm先进制程,集成双核Cortex-A73大核与六核Cortex-A53小核的八核架构。内置4TOPS NPU,端侧AI算力强劲。图形处理方面,集成Mali-G310 GPU,支持Vulkan 1.4图
高性能计算用户论坛(HPCUF)于美国当地时间5月5—6 日在得克萨斯州奥斯汀举办,本次盛会再度汇聚国家实验室、学术界及行业领军人物,共同探讨高性能计算的未来发展。AMD 以赞助商身份参与这场重要行业盛会,进一步巩固自身在HPC 与 AI 融合领域的前沿引领地位。 会上,AMD提前展示了其新一代加速器——AMD Instinct™ MI430X GPU。这款产品并非追赶AI低精度算力潮流的常规迭代
现在的AI圈,说一句“卷疯了”一点不夸张。不管是刚起步的小公司,还是手握资源的大厂,全都挤在AI风口上不肯下来。小公司一门心思做垂直小模型,啥教育、办公、剪辑,每个细分领域都挤得满满当当;大厂则忙着做表层应用,换个皮、加个功能就敢说是新产品;资本更直接,只看短期能不能赚钱、有没有流量,根本不管长期发展。 有行业报告统计,超过70%的AI相关企业,都在盯着单一赛道死磕——要么在某个细分场景的小模型上
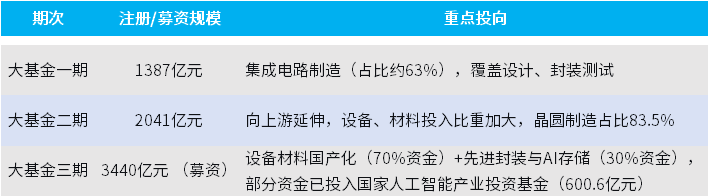
5月6日,一则报道引发市场高度关注:国家集成电路产业投资基金(简称“国家大基金”)正在洽谈领投DeepSeek首轮融资,估值约450亿美元。 几周前,这一数字还停留在200亿美元左右,短短数周翻倍有余,市场用真金白银给出了答案。 国家大基金向来被视为中国半导体产业的“国家队”,重点投向材料、设备、芯片制造等产业链,此前从未公开投资任何一家大语言模型公司。一旦本轮投资落地,这将是大基金首次公开注资本
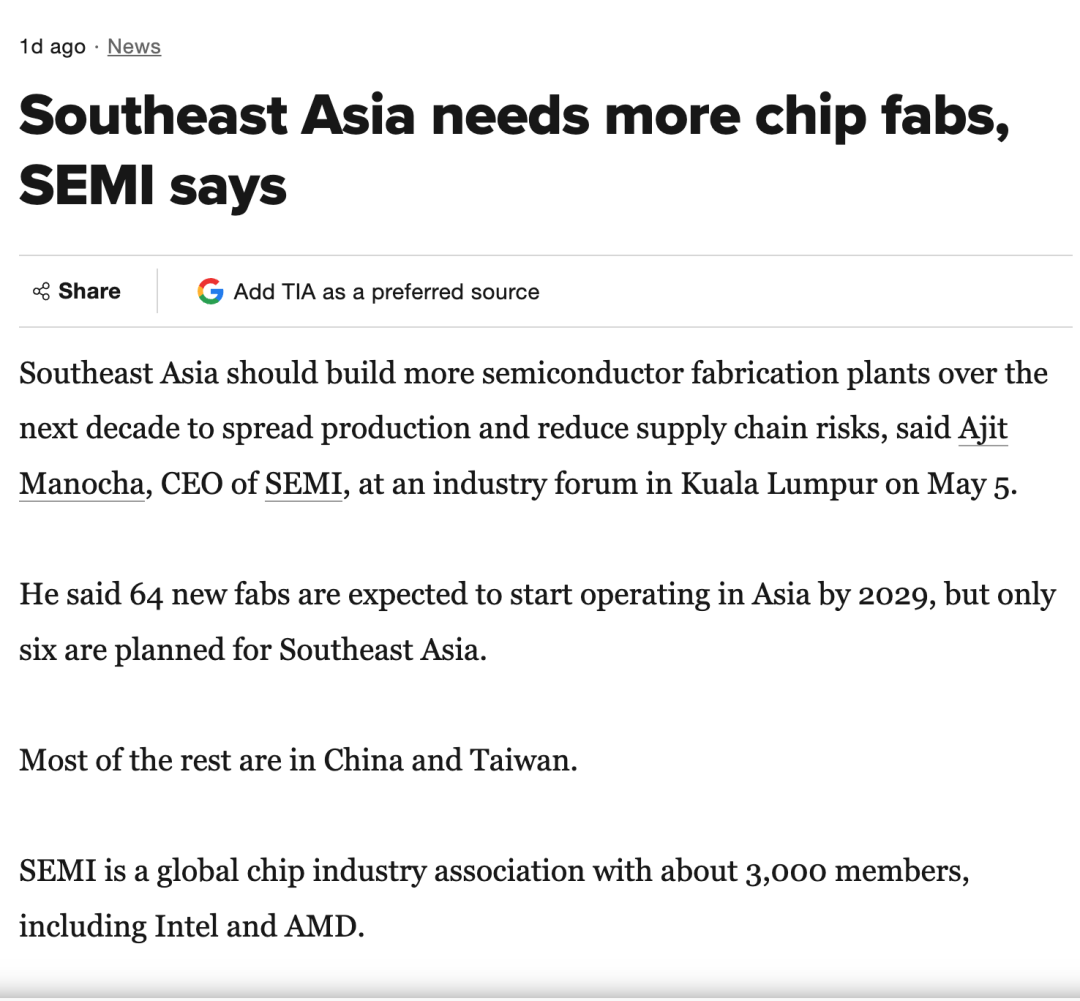
亚洲需要更多晶圆厂 SEMI表示,尽管受中东危机、贸易不确定性及原材料短缺影响,半导体需求激增势头仍将持续;受AI数据中心推动,今年全球半导体销售额预计达1万亿美元,2035年将翻倍至2万亿美元。地缘政治风险今年难抑行业繁荣,但原材料短缺可能影响长期前景,各国正解决关键矿物及溴、氦等关键气体的短缺问题,其中氦气因中东局势3月价格大幅上涨,溴也面临短缺风险。 SEMI首席执行官建议:东南亚未来十年多
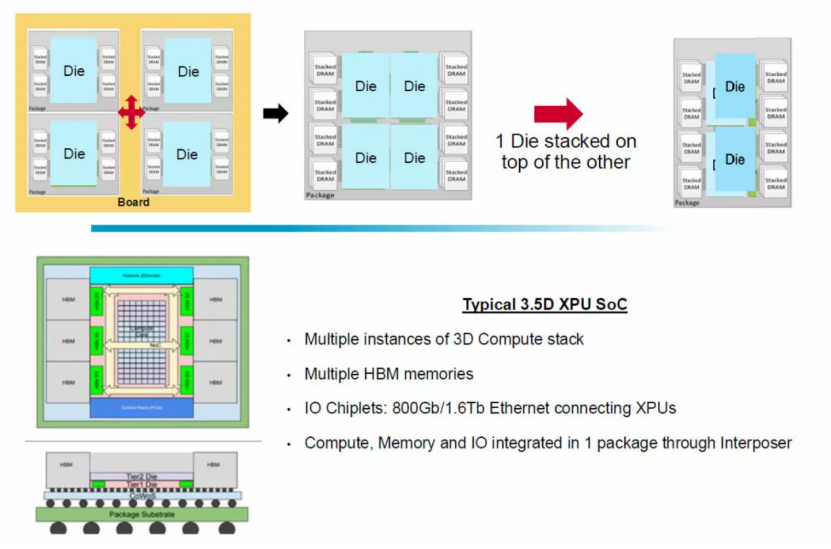
为降低芯片组件间延迟,同时在单封装内为计算引擎及网络专用集成电路集成更多电路,芯片设计厂商跳出二维平面架构、开启元器件垂直堆叠已是大势所趋。 高带宽内存(HBM)堆叠已率先实现 DRAM 内存的垂直化。相较于负责数据传输与运算的专用芯片,内存芯片功耗更低,因此 HBM 堆叠的实现难度相对更低。业界现已采用 2.5D 堆叠技术,通过中介层将 GPU、XPU 等计算芯片与 HBM 堆叠内存互连;AMD
内存市场今年面临严峻挑战。由于制造商优先为数据中心和大规模AI工作负载供应DDR5和高带宽内存(HBM),内存供应趋紧,成本大幅飙升:与2025年第三季度相比,价格已上涨了3至4倍,且市场信号表明价格峰值尚未到来。 据报道,即便是通常处于市场优先级的超大规模云厂商,也仅获得了约70%的分配容量。分析师预计,这种紧张局面将贯穿2026年全年,甚至可能延续至2027年。 这种压力并非均匀分布。价格涨幅

2026年5月6日,全球半导体资本市场迎来一场罕见的集体狂欢。 美股层面,截至北京时间5月6日19:00左右,道指期货涨1.13%,纳指期货涨1.59%,标普500期货涨0.96%。半导体股盘前走势尤为强劲:AMD飙涨近20%,ARM涨超12%,英特尔、蓝博士半导体(Rambus)涨超5%;存储概念巨头继续走强,美光科技、闪迪涨超5%,西部数据涨超3%,希捷科技涨超2%。前一交易日(5月5日),费
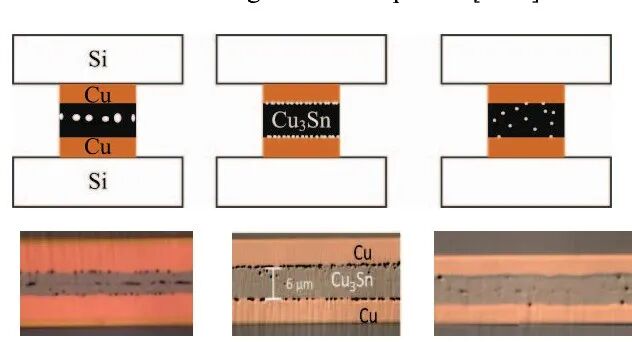
本文介绍了固液互扩散键合的基本原理、材料体系和优势。 固液互扩散键合基本原理? SLID 全称 Solid-Liquid Interdiffusion Bonding,中文也叫瞬态液相键合,核心思路是: 用低熔点金属在较低温度下液化,与高熔点金属互扩散形成金属间化合物,而这个化合物的熔点远高于最初的键合温度。 材料体系? 低熔点金属:常用的有锡 (Sn) 和铟 (In)。 高熔点金属:主要使用
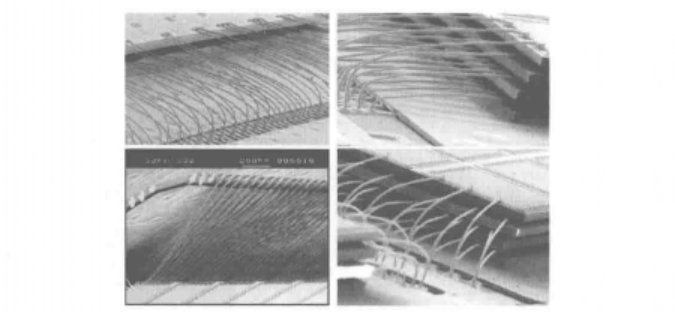
本文介绍了细节距键合的定义和可靠性与测试。 细节距球形键合 2008年生产的大多数器件的针脚数仍然很少(<100),用于这种球形键合的键合焊盘节距仍在80~100μm范围内。但是,目前制造的高端器件的主流节距为40μm,后面的图5给出了一个类似细节距球形键合的示例,而且35μm节距球形键合的器件在2008年就接近批量生产了。下图1给出了一个使用25μm线径Au丝在70μm节距上进行球形键合的

本文介绍了TC Wafer 与 RTD Wafer的定义与作用 在半导体制造过程中,晶圆在工艺腔室内的真实温度变化直接影响芯片良率。测温晶圆通过将测温元件直接嵌入真实晶圆,能够深入腔室实地测量,提供最贴近生产的温度数据,成为工艺调试与设备验证的可靠依据。 共同作用 无论是 TC Wafer 还是 RTD Wafer,其核心目标均是发现工艺中的“热点”或“冷点”,保证每片晶圆的一致性,最终提升良率。
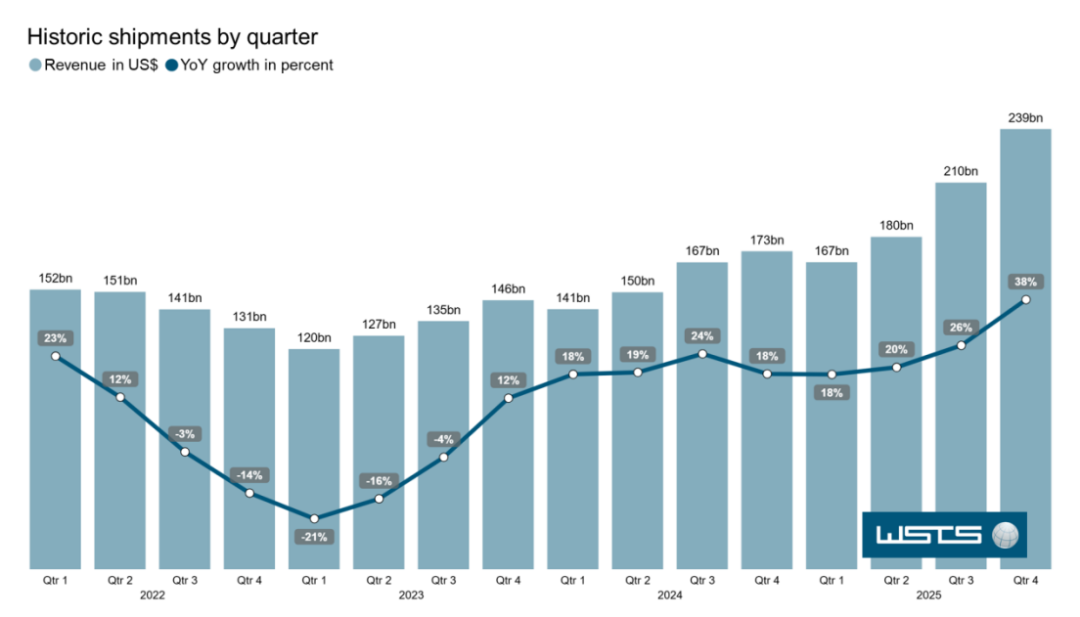
2025年,全球半导体产业在人工智能算力需求爆发、云计算基础设施升级及存储市场全面复苏的推动下,交出了一份历史性的答卷。根据美国半导体行业协会(SIA)基于世界半导体贸易统计组织(WSTS)的数据,2025年全球半导体销售额达到7917亿美元,较2024年的6305亿美元同比增长25.6%,创下历史最高年度销售纪录。 其中,逻辑半导体增长39.9%至3019亿美元,存储半导体增长34.8%至22
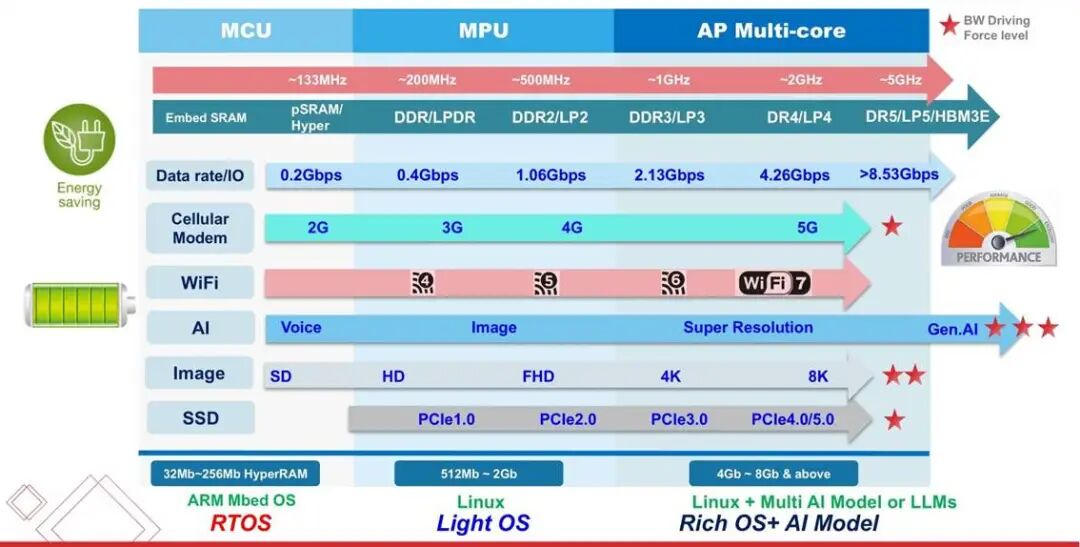
随着高性能计算(HPC)工作负载日益复杂,生成式人工智能(AI)正逐步集成到现代系统中,从而推动了对先进内存解决方案的需求。为了满足这些不断变化的需求,业界正在开发下一代内存架构,旨在最大化带宽、最小化延迟并提高能效。 DRAM、LPDDR和专用内存解决方案的技术进步正在重新定义计算性能,其中AI优化内存发挥着关键作用,有助于提升效率和可扩展性。本文将探讨内存技术的最新突破,以及AI应用对内存设计
