波鸿鲁尔大学等发布随机化缓存开销与限制研究
波鸿鲁尔大学、马克斯·普朗克安全与隐私研究所和佐治亚理工学院研究人员实现四种随机化缓存设计,并集成到多核乱序RISC-V SoC。FPGA评估显示,延迟与关键路径造成频率和性能损失,资源开销因设计而异。
FPGA(现场可编程门阵列)通过可配置逻辑块(CLB)、高速 SerDes 收发器与 DSP 切片,提供超低延迟的硬件级并行信号处理能力。广泛用于通信基带、工业多轴伺服控制、高速数据采集、视频图像拼接及 ASIC 原型验证。 纳米网专题目前已聚合 30 篇深度内容(覆盖电路设计、工业自动化、嵌入式开发等方向,最近更新于2026年11月),代表性技术议题包括《波鸿鲁尔大学等发布随机化缓存开销与限制研究》《微芯科技PolarFire平台新增EtherCAT与TSN方案》等。
波鸿鲁尔大学、马克斯·普朗克安全与隐私研究所和佐治亚理工学院研究人员实现四种随机化缓存设计,并集成到多核乱序RISC-V SoC。FPGA评估显示,延迟与关键路径造成频率和性能损失,资源开销因设计而异。
微芯科技扩展工业边缘网络方案栈,在PolarFire FPGA与SoC上支持倍福EtherCAT IP和微芯TSN IP,实现确定性实时以太网通信,面向AI自动化、机器人及工业4.0应用。

本文重点介绍了那些挑战设计人员探索新型边缘AI 架构的应用场景及其相关要求。然后介绍了Altera 提供的支持边缘 AI 的现场可编程门阵列(FPGA) 器件和软件工具,并展示了如何利用它们来满足这些应用在广泛性能和功率点上的需求。 网络边缘的AI(边缘 AI)很少仅仅意味着推理。现实世界的部署通常涉及高速输入/输出 (I/O)、信号调节和实时控制回路,所有这些都是并发执行的。这些多功能工作负载要

最近,硬件玩家 Alex Anderson-McLeod 用一块 FPGA,成功“重制”了 1983 年的 Apple Lisa —— 也就是苹果第一台真正意义上的 GUI 图形界面电脑。 很多人以为 Macintosh 才是苹果 GUI 的起点,其实 Lisa 才是真祖。 只是当年它卖到 9995 美元,放到今天相当于 3 万多美元,最终因为价格太离谱、软件生态太少而失败。 但有意思的是:
PolarFire® FPGA助力4K / 8K机器视觉快速落地 如果您正在做高速成像或机器视觉系统开发,那么好消息来了——只用一套PolarFire FPGA生态,就能同时搞定SDI、SLVS-EC 和 CoaXPress™接口! PolarFire FPGA 通过统一的平台,大幅简化设计流程,让复杂的视频接口开发变得更高效、更可控。 三种方式,全面加速您的下一代设计 SDI Rx/Tx I
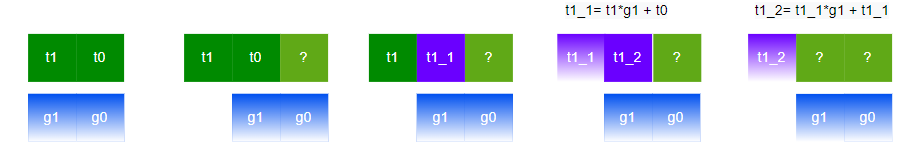
前言 在很多以太网、SATA 或其他高速接口项目中,我们经常会接触到 CRC(循环冗余校验)。通常,工程师会通过网站或软件工具生成一整套带异或操作的组合逻辑来实现 CRC 算法,而不去深入理解其原理——只知道可以这样用。事实上,在大多数情况下,确实不需要了解 CRC 的具体实现方法,这种黑盒化的使用方式在低频窄位宽场景下确实可行。 但是,当你的系统时钟非常高,例如 800MHz、1GHz,且数据位
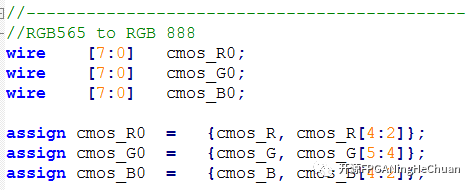
前面我们讲了基于FPGA用VGA显示一副静态图片,那么接下来我们就接着前面的工程来实现我们图像处理的基础算法里最简单的一个那就是彩色图像转灰度的实现。 将彩色图像转化为灰度的方法有两种,一个是令RGB三个分量的数值相等,输出后便可以得到灰度图像,另一种是转化为YCbCr格式,将Y分量提取出来,YCbCr格式中的Y分量表示的是图像的亮度和浓度所以只输出Y分量,得到的图像就是灰度图像了。我在这里选
学生期间,做的设计比较小或者偏向 demo 类型,那么 ip 核是会占据设计的很大一部分。但使用 ip 核本身对学习者来说就很有意义。通过 ip 的使用,会了解一个工程如何组织,如何阅读手册,如何通过仿真结果优化修改自己的设计。本系列就会通过使用一系列的基础 ip,讨论如何组织工程,阅读手册,编写基础的粘合逻辑,testbench 以及功能仿真。 使用 ip 对于数字逻辑方面的工
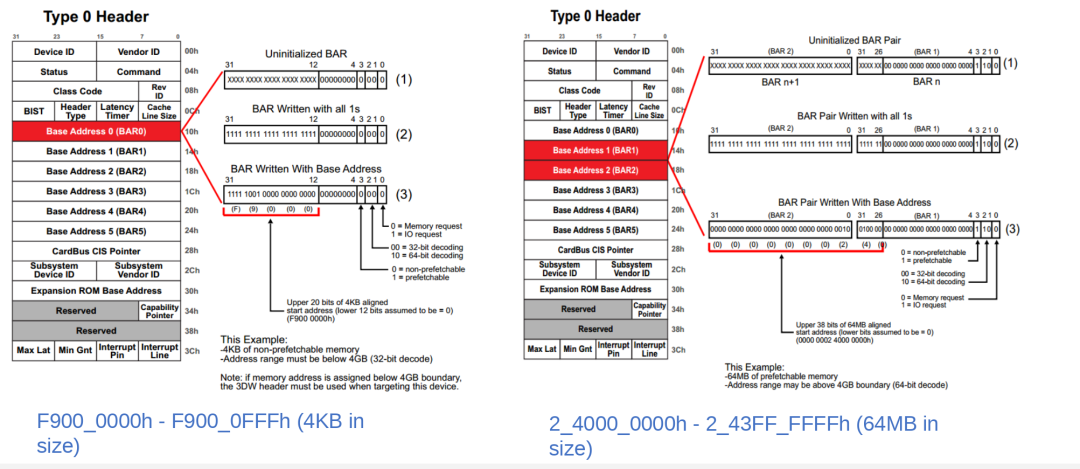
前言 对于主机而言,FPGA-PCIe 设备通过其 BAR(Base Address Register)被识别和访问。主机必须通过读写 BAR 所映射的地址空间,才能与 FPGA-PCIe 正确通信。这相当于将 FPGA-PCIe 内部的地址区域映射到主机的内存空间中,主机通过访问这段内存来完成数据收发。 readl(dif->bar0_mapped_addr + (offset<&l
之前学习了半年的图像处理,所以计划将自己学过的几个图像处理的基础算法,做过的设计记录下来,在OpenHW论坛上发表,计划是这样的,用VGA做显示,使用PC端上位机通过串口发送一幅图片数据到FPGA开发板,FPGA接收数据并做处理最终发送给VGA显示屏显示,计划要写的算法有彩色图像转灰度、均值/中值滤波、Sobel边缘检测等。那么现在这是第一篇,先来写VGA显示的驱动、以及将一幅图片显示到VGA显示
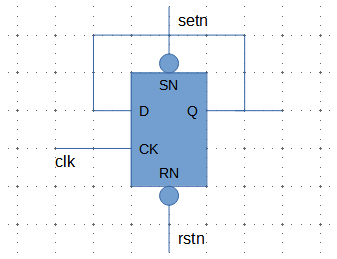
有群友提问,下面的代码为什么在DC里可以综合成DFF,而在FPGA上却综合成了latch。 always@(posedge clk, negedge rstn, negedge setn) if(!rstn) a <= 1'b0; else if(!setn) a <= 1'b1; else a <= a; 我们可以看到这段代码有两个特别之处: 同时有异
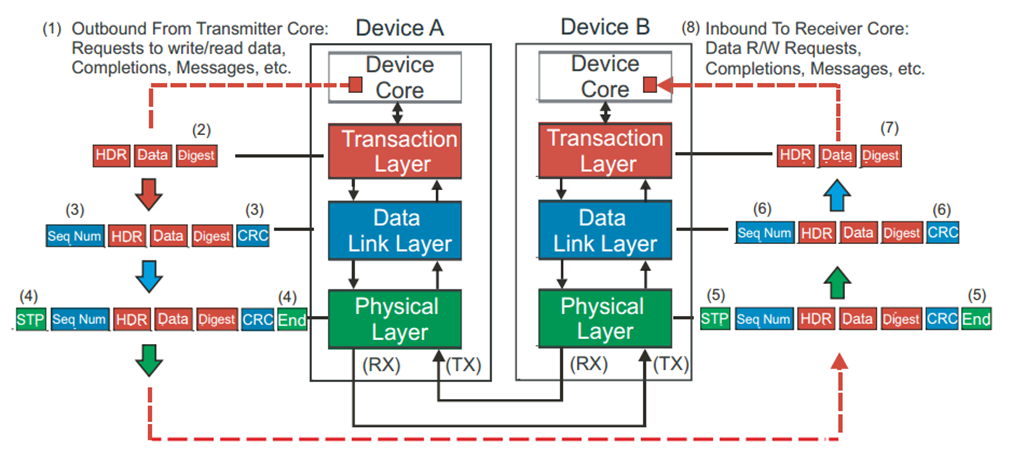
前言 本系列不会从零讲PCIe,也不会照搬规范条款,标准文档已经够厚,这里更像是一份工程师视角下的PCIe手边笔记 , 以更简洁的方式记录PCIe的关键点。 TLP包 由于PCIe-DMA的实现始终在事务层通过TLP包完成,因此深入理解TLP包的构成至关重要。 TLP包所在位置 在PCIe协议的传输层中,TLP包的结构相较于链路层与物理层的报文而言,最为简单清晰。 TLP的结构 TLP的结构
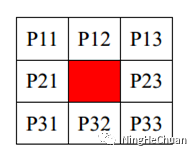
前面实现了基于FPGA的彩色图像转灰度处理,减小了图像的体积,但是其中还是存在许多噪声,会影响图像的边缘检测,所以这一篇就要消除这些噪声,基于灰度图像进行图像的滤波处理,为图像的边缘检测做好夯实基础。 椒盐噪声(salt & pepper noise)是数字图像的一个常见噪声,所谓椒盐,椒就是黑,盐就是白,椒盐噪声就是在图像上随机出现黑色白色的像素。椒盐噪声是一种因为信号脉冲强度引
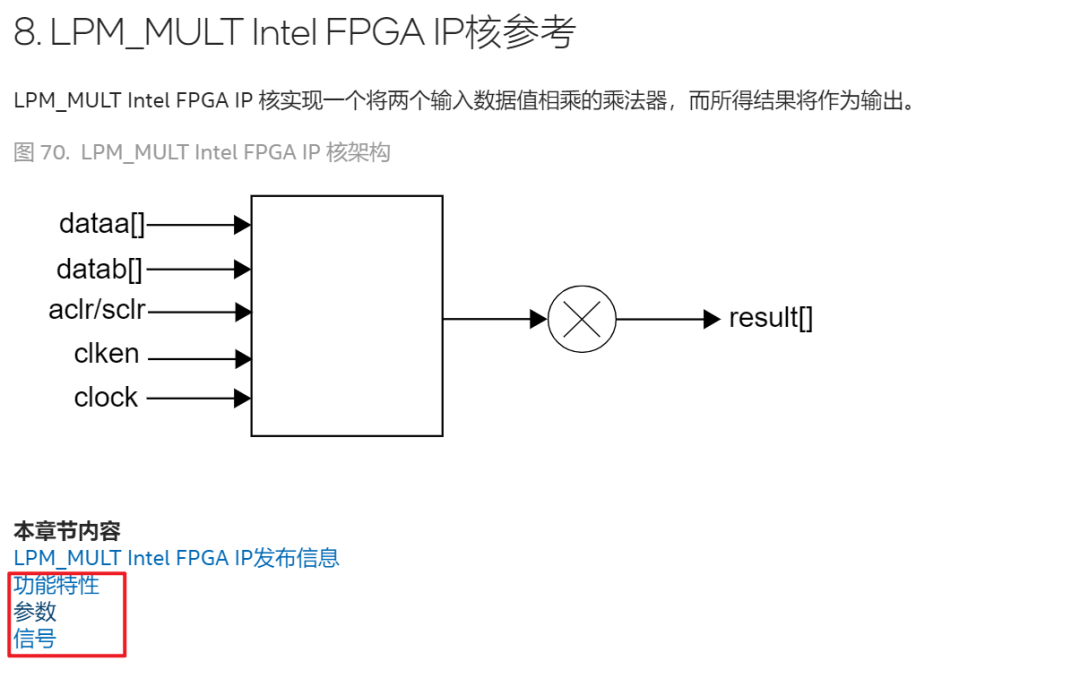
在进行编码时,我们时常会使用到乘法器,除法器,等较复杂功能模块,为此fpga vendor设计定制了IP核,用户通过调用IP核来实现所需功能,耗费资源少且利于时序收敛。我们在日常verilog编码过程期望通过参数化的方式调用IP核。例如IP的位宽,时延,部分关键特性期望可以通过参数调用的方式实现,而不是通过打开GUI界面通过手动选择的方式实现。其实实现方式很简单。首先通过手动打开quart
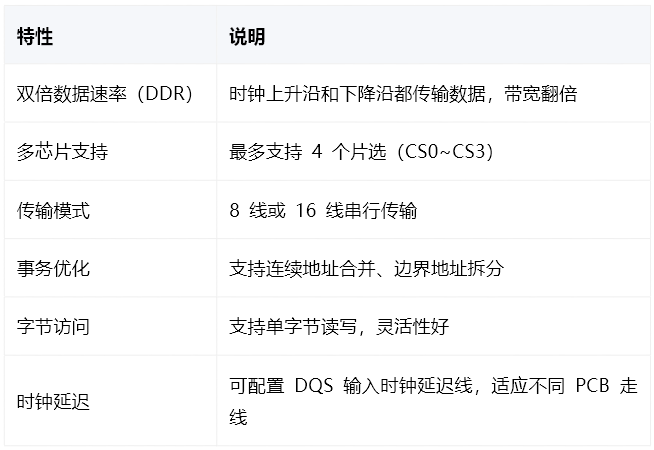
在工业控制和数据采集场景中,处理器与 FPGA 之间的高速数据交换是一个常见需求。传统方案通常采用 SPI(速度受限,一般 < 10Mbps)或 PCIE(带宽高但引脚多、设计复杂)。有没有一种方案,既能达到 几十 MB/s 的带宽,又只需要少量引脚,设计简单? 今天分享一个基于 睿擎派 RC3506 的方案——利用 RK3506 芯片内置的 DSMC(Double Data Rate Se
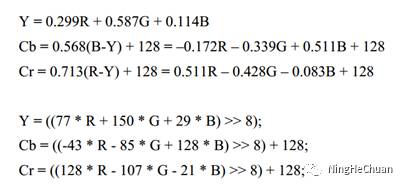
将彩色图像转化为灰度的方法有两种,一个是令RGB三个分量的数值相等,输出后便可以得到灰度图像,另一种是转化为YCbCr格式,将Y分量提取出来,YCbCr格式中的Y分量表示的是图像的亮度和浓度所以只输出Y分量,得到的图像就是灰度图像了。我在这里选择第二种方法实现。 YCBCr是通过有序的三元组来表示的,三元由Y(Luminance)、Cb(Chrominance-Blue)和Cr(Chrom
前言 开源 AFX-SATA-DMA 控制器:高速存储接口的完整实现(附源码) SATA 的开源并不是我的主要目的。这个项目最初的出发点,其实是想借此验证和实践 cocotb 仿真的完整流程,以及构建一套自主可控的 FPGA 开发工具链。可以说,是为了这点醋,才包了这顿饺子。不过既然 SATA 协议都已经实现出来了,索性就把它开源出来。开源的好处是双向的:对大家来说,可以借此深入学习SATA 协议
在设置input_delay时,我们经常会使用下面的方式: set_input_delay -clock clk -min 2 [get_ports data_in] set_input_delay -clock clk -max 4 [get_ports data_in] 但有时也会在后面增加一个-add_delay的参数: set_input_delay -clock clk -max 2.1
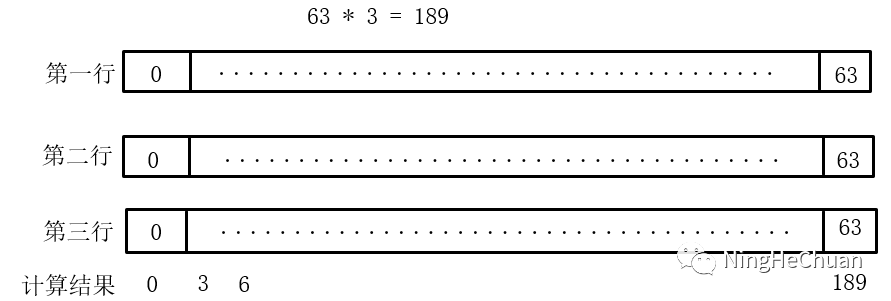
实验:FPGA**计算3**行同列数据之和 实验要求:PC机通过串口发送3行数据(一行有56个数据,3行共有56*3=168个数据)给FPGA,FPGA计算3行同一列数据的和,并将结果通过串口返回给上位机。 实现方法:使用两个FIFO IP Core,将串口接收到的数据进行缓存,当第一个FIFO1的数据存满后,将FIFO1的数据读出来给FIFO2,当FIFO2的数据存满时,当前两个FIFO的数据和
前言 在做这个实验的时候在网上找了许多资料,都是关于使用单片机驱动LCD显示,确实用单片机驱动是要简单不少,记得在FPGA学习交流群里问问题的时候,被前辈指教,说给我最好的指教便是别在玩这个了,多看看关于FPGA方面的书籍,比做这个单片机做的东西价值强多了。现在想来确实,自从学习FPGA以来,看过的书没有多少,只是想做个什么了,就在网上找找例程,照抄下来,把算法推理一遍,下个板子实现