今年6月,超威接管了名为MEXT的预测式内存引擎。该技术声称可在仅使用低至25%物理DIMM的情况下,提供完整DRAM容量系统99%以上的性能。这项技术会把冷内存页面卸载到闪存存储,并使用AI模型在页面被需要之前提前准备页面。超威表示,计划明年将该技术推广到其大范围IT基础设施。
MEXT背后的设想看起来好得令人难以置信。据超威和MEXT创始人Gary Smerdon表示,根据应用和性能目标不同,该技术可将服务器所需物理DRAM削减20%至75%。这部分缺失的内存在操作系统中仍显示为已安装DRAM。不过,MEXT并不使用DRAM,而是使用相对便宜的闪存存储来卸载冷页面,并通过AI模型在需要时将这些页面快速调回。在超威的一些内部工作负载中,例如新思科技PrimeTime,该公司表示使用MEXT在50% DRAM容量下运行时,可实现完整服务器95%的性能。
超威已在内部145台服务器上部署MEXT,并表示明年将扩展到2000台服务器。此外,该公司还宣布与慧与合作,向客户推出MEXT。目前,该推广处于第一阶段,部分霄龙Venice服务器带有“MEXT Ready”标识,并配备用于卸载的专用NVMe驱动器或托架。第二阶段将向这些服务器推出MEXT许可证,以及RAM View应用程序。超威尚未说明第二阶段何时开始。
AI驱动的DRAM价格上涨影响的不仅是游戏PC,企业也在承受涨价压力,即使它们并未运行AI工作负载。如果MEXT能够实现超威所声称的效果,在当前市场环境下可能带来变革性影响。因此,值得了解MEXT究竟是什么,以及超威声称它能做到什么。
尽管MEXT在概念上令人兴奋,但显然超威正在采取保守的推广方式。毕竟,不同寻常的说法需要不同寻常的证据。MEXT目前的应用范围仍然较窄,不过超威表示正在扩展使用MEXT的工作负载,并已取得有前景的早期结果。
MEXT的基本构想在概念上很简单:冷页面进入闪存,AI在需要时把这些页面调回,就好像这些内存从未缺失一样。主要问题显而易见。闪存比DRAM慢几个数量级,因此在需要时才从闪存把页面流式传回内存并不可行。MEXT的技巧是使用AI模型预测需要的页面。只要该模型的预测能够至少领先于从SSD传输数据所需的延迟,效果就好像物理DRAM一直安装着一样。
考虑到MEXT使用的基于Transformer的大语言模型如何运作,这并不是一个疯狂的概念。如果不熟悉其内部工作原理,这个开源可视化项目清晰拆解了Transformer AI模型的概念。基础概念是下一个词元预测,它支撑着现代大语言模型的设计。给定一组词元,大语言模型会判断哪个词元(词、词的一部分等)最可能出现在下一个位置。它会做出预测。在MEXT的场景中,它预测的是下一个需要的页面,而不是下一个词。
将内存卸载到闪存并不是一个新概念,但MEXT创始人Gary Smerdon表示,AI是这项技术的关键差异。MEXT本身作为Linux内核模块部署,可与任何Linux发行版配合使用。它使用“一组AI模型”,其中主要的基于Transformer的大语言模型驱动该技术。而且关键是,它并非预训练模型。
超威表示,MEXT在首次部署时可在一秒内完成训练,在一个霄龙核心上运行且不需要GPU,并会随着工作负载推进持续训练。考虑到MEXT可能适用的各种工作负载,这种方式是合理的。其思路是学习应用程序的访问模式,从而驱动该预测引擎。
MEXT并不完美,但它也不需要在每种情况下都完美。例如,存储页面的顺序并不重要。对于文本,大语言模型需要按正确顺序预测正确文本,但对于MEXT,顺序并不重要。只要页面在需要时位于DRAM中,就可以。
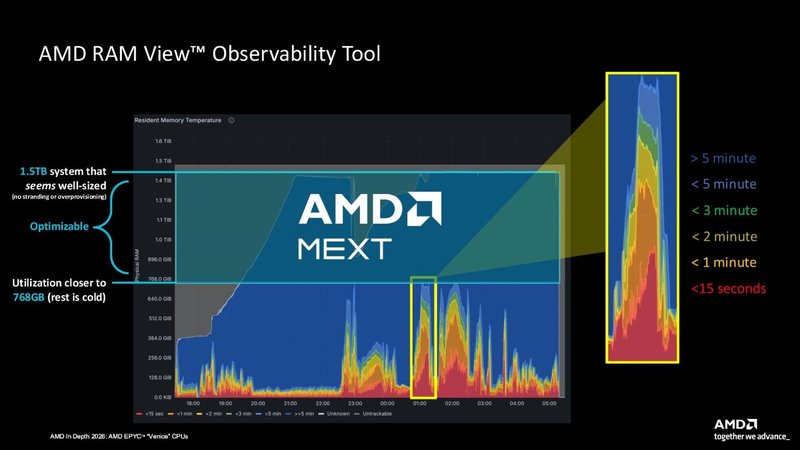
为了理解MEXT在不同工作负载中的应用,超威还开发了配套工具RAM View。这是一个内存利用率工具,可显示哪些页面是热页面,哪些已经变冷。如上例所示,一台配备1.5TB内存的系统在整个工作负载中显示接近满利用率,但在任意给定时间,存储在内存中的页面约有半数在五分钟或更长时间内未被访问。
超威提供的是通用示例,并未说明测试的具体工作负载。这一点非常重要,因为根据服务器上运行的应用不同,内存利用率分布会有很大差异。最初,超威正在将MEXT应用于其内部关键EDA应用,例如新思科技PrimeTime,但该公司表示也在聚焦优化智能体AI、数据库、媒体与娱乐工作负载。
这一点之所以重要,不仅因为不同应用之间的内存访问模式不同,还因为当系统内存不足时,不同应用的性能表现也会有不同反应。超威所称的“内存墙”,无论是否接触过服务器,都应是一个熟悉的概念。超威表示,MEXT试图延展这堵内存墙,而对不同应用来说,这堵墙可能呈现不同形态。
例如,该公司相信许多工作负载可以将容量削减约20%至25%。但随着削减幅度增加,应用会变得更加专门化,性能差距也会更大。
超威内部MEXT结果
超威分享了一些内部MEXT结果。这些结果看起来很出色,不过一如既往地,对这类第一方基准测试保持审慎是明智的。从超威迄今为止在MEXT上投入大量关注的PrimeTime开始,该公司表示,在50%容量下运行的服务器保留了完整服务器95%的性能;即使容量降至低至25%,仍可保持该应用80%的性能。
PrimeTime在大型设计中需要大量内存。超威称,有一些应用的性能几乎相同。在Azure中运行、采用第五代霄龙CPU的三节点集群中,超威表示,在运行TPC-DS基准中的Spark SQL工作负载时,MEXT在50% DRAM容量下可提供完整集群99%的性能。SQL数据库会尽可能把更多数据缓存在内存中,以避免I/O瓶颈,这为希望释放冷页面的MEXT之类技术创造了良好机会。
然而,当前最具适用性的工作负载或许是智能体AI,超威表示MEXT在那里也有类似应用。在五个智能体并发的几何平均值中,超威声称在50%内存容量下可达到完整服务器99%的性能,在25%容量下可达到85%。对于一个内存需求高的智能体,超威声称在50%和25%容量下分别可达到90%和88%的性能。
上面这张幻灯片带有脚注标记。不过,超威尚未提供脚注,因此无法了解这些测试是如何运行的。自然地,可以假设超威至少尽可能以最好的一面呈现MEXT性能。但在不知道测试方式的情况下,无法进行完整分析。
有趣的是超威对MEXT推广的谨慎态度。目前它是霄龙专属功能,不过超威为未来产品支持留了门,例如消费类设备(如Strix Halo)可能在更远的未来获得支持。它将以许可证形式销售,并与RAM View软件捆绑,但目前尚无相关时间表。而且,尽管超威与慧与合作推广“MEXT Ready”服务器,仍不知道MEXT本身何时才能准备好在超威之外部署。
鉴于这种保守做法,MEXT可能还存在一些尚未显现的潜在问题,而且很难想象它会广泛适用于每一台服务器,至少难以达到超威基准测试中展示的50%和25% DRAM容量水平。
不过,即便只是削减服务器25%的DRAM容量,在当前供应紧张环境下也意味着巨大的成本节约。如果某些工作负载能将其推进到50%容量,那就更好。当然,还需要看MEXT在广泛可用后的表现,但如果超威的说法站得住脚,它可能成为那些似乎总也得不到足够内存的数据中心中的决定性技术。
来源: 海外媒体
登录后即可参与技术讨论与同行交流
免费注册