过去几年,AI基础设施一直处于算力竞赛之中。更多加速器、更大规模异构集群和更高峰值性能,使模型能力不断增强。随着AI走向大规模部署,基础设施必须支持更多用户、更大模型、更长上下文窗口和更复杂应用。性能仍然重要,但时延、功耗、利用率、可预测性以及每次推理的成本同样重要。
这一挑战不仅限于带宽。AI系统必须平衡内存容量、带宽、时延、功耗、数据移动、利用率和成本。改善某一维度可能会给其他方面带来压力。键值(KV)缓存说明了这种取舍。KV缓存可减少生成式AI推理中的重复计算,但要求系统保留并反复访问不断增长的数据。随着上下文长度和并发请求增加,这种取舍变得更加明显。
其结果并不只是又一个内存瓶颈,而是计算、内存、互连和软件之间的协调问题。只有当系统能够放置、移动和取回数据,同时不让时延、拥塞、功耗或复杂性抵消收益时,增加容量或带宽才有帮助。
内存墙正在变宽
内存墙早在AI之前就已存在。历史上,处理器性能提升速度一直快于内存系统向处理器供应数据的能力。AI放大了这一问题。如果加速器花更多时间等待数据,提升算术吞吐量带来的收益有限。
但带宽只是约束的一部分。AI系统还需要足够容量来存放模型、中间数据、应用上下文和推理状态。时延影响响应速度。功耗限制了在经济上可移动的数据量。封装和物理连接限制了能在计算附近放置多少高性能内存。
这些需求经常相互冲突。靠近加速器的高带宽内存可以提供极高带宽,但其容量、功耗和成本受限。容量更大的内存可能更经济,但未必能提供相同带宽或时延。在层级之间移动数据可以扩大有效容量,但会消耗带宽、功耗和时间。
因此,内存墙正在成为多维度的系统约束。
图1:AI扩展使内存墙成为带宽、容量、时延、功耗、成本和利用率之间的系统级取舍。
一个系统可能拥有可观的总内存,但并非所有容量都同样有用。较低层级中的数据在技术上可能可用,但仍可能因距离太远、路径拥塞或移动成本过高,而无法满足应用的服务级别目标(SLO)。
实际限制不只是已安装容量,而是在工作负载时延、带宽和功耗范围内的可用容量。
推理改变经济逻辑
训练大模型需要巨大计算资源和内存带宽,但本质上是一个构建或更新模型的过程。推理是动态且持续的过程。每一次提示、每一个生成的词元、每一个智能体动作和每一次应用交互,都会消耗基础设施资源。
推理也不是单一工作负载。对话助手可能更重视时延。企业AI助手可能在支持大量用户的同时处理大量专有上下文。AI智能体可能在多个步骤中保留信息。消费者服务可能优先考虑吞吐量和每词元成本。批量推理可能更重视利用率。
每种场景都会在带宽、容量、时延、功耗和成本之间形成不同的平衡。架构必须跟随工作负载。
KV缓存凸显取舍
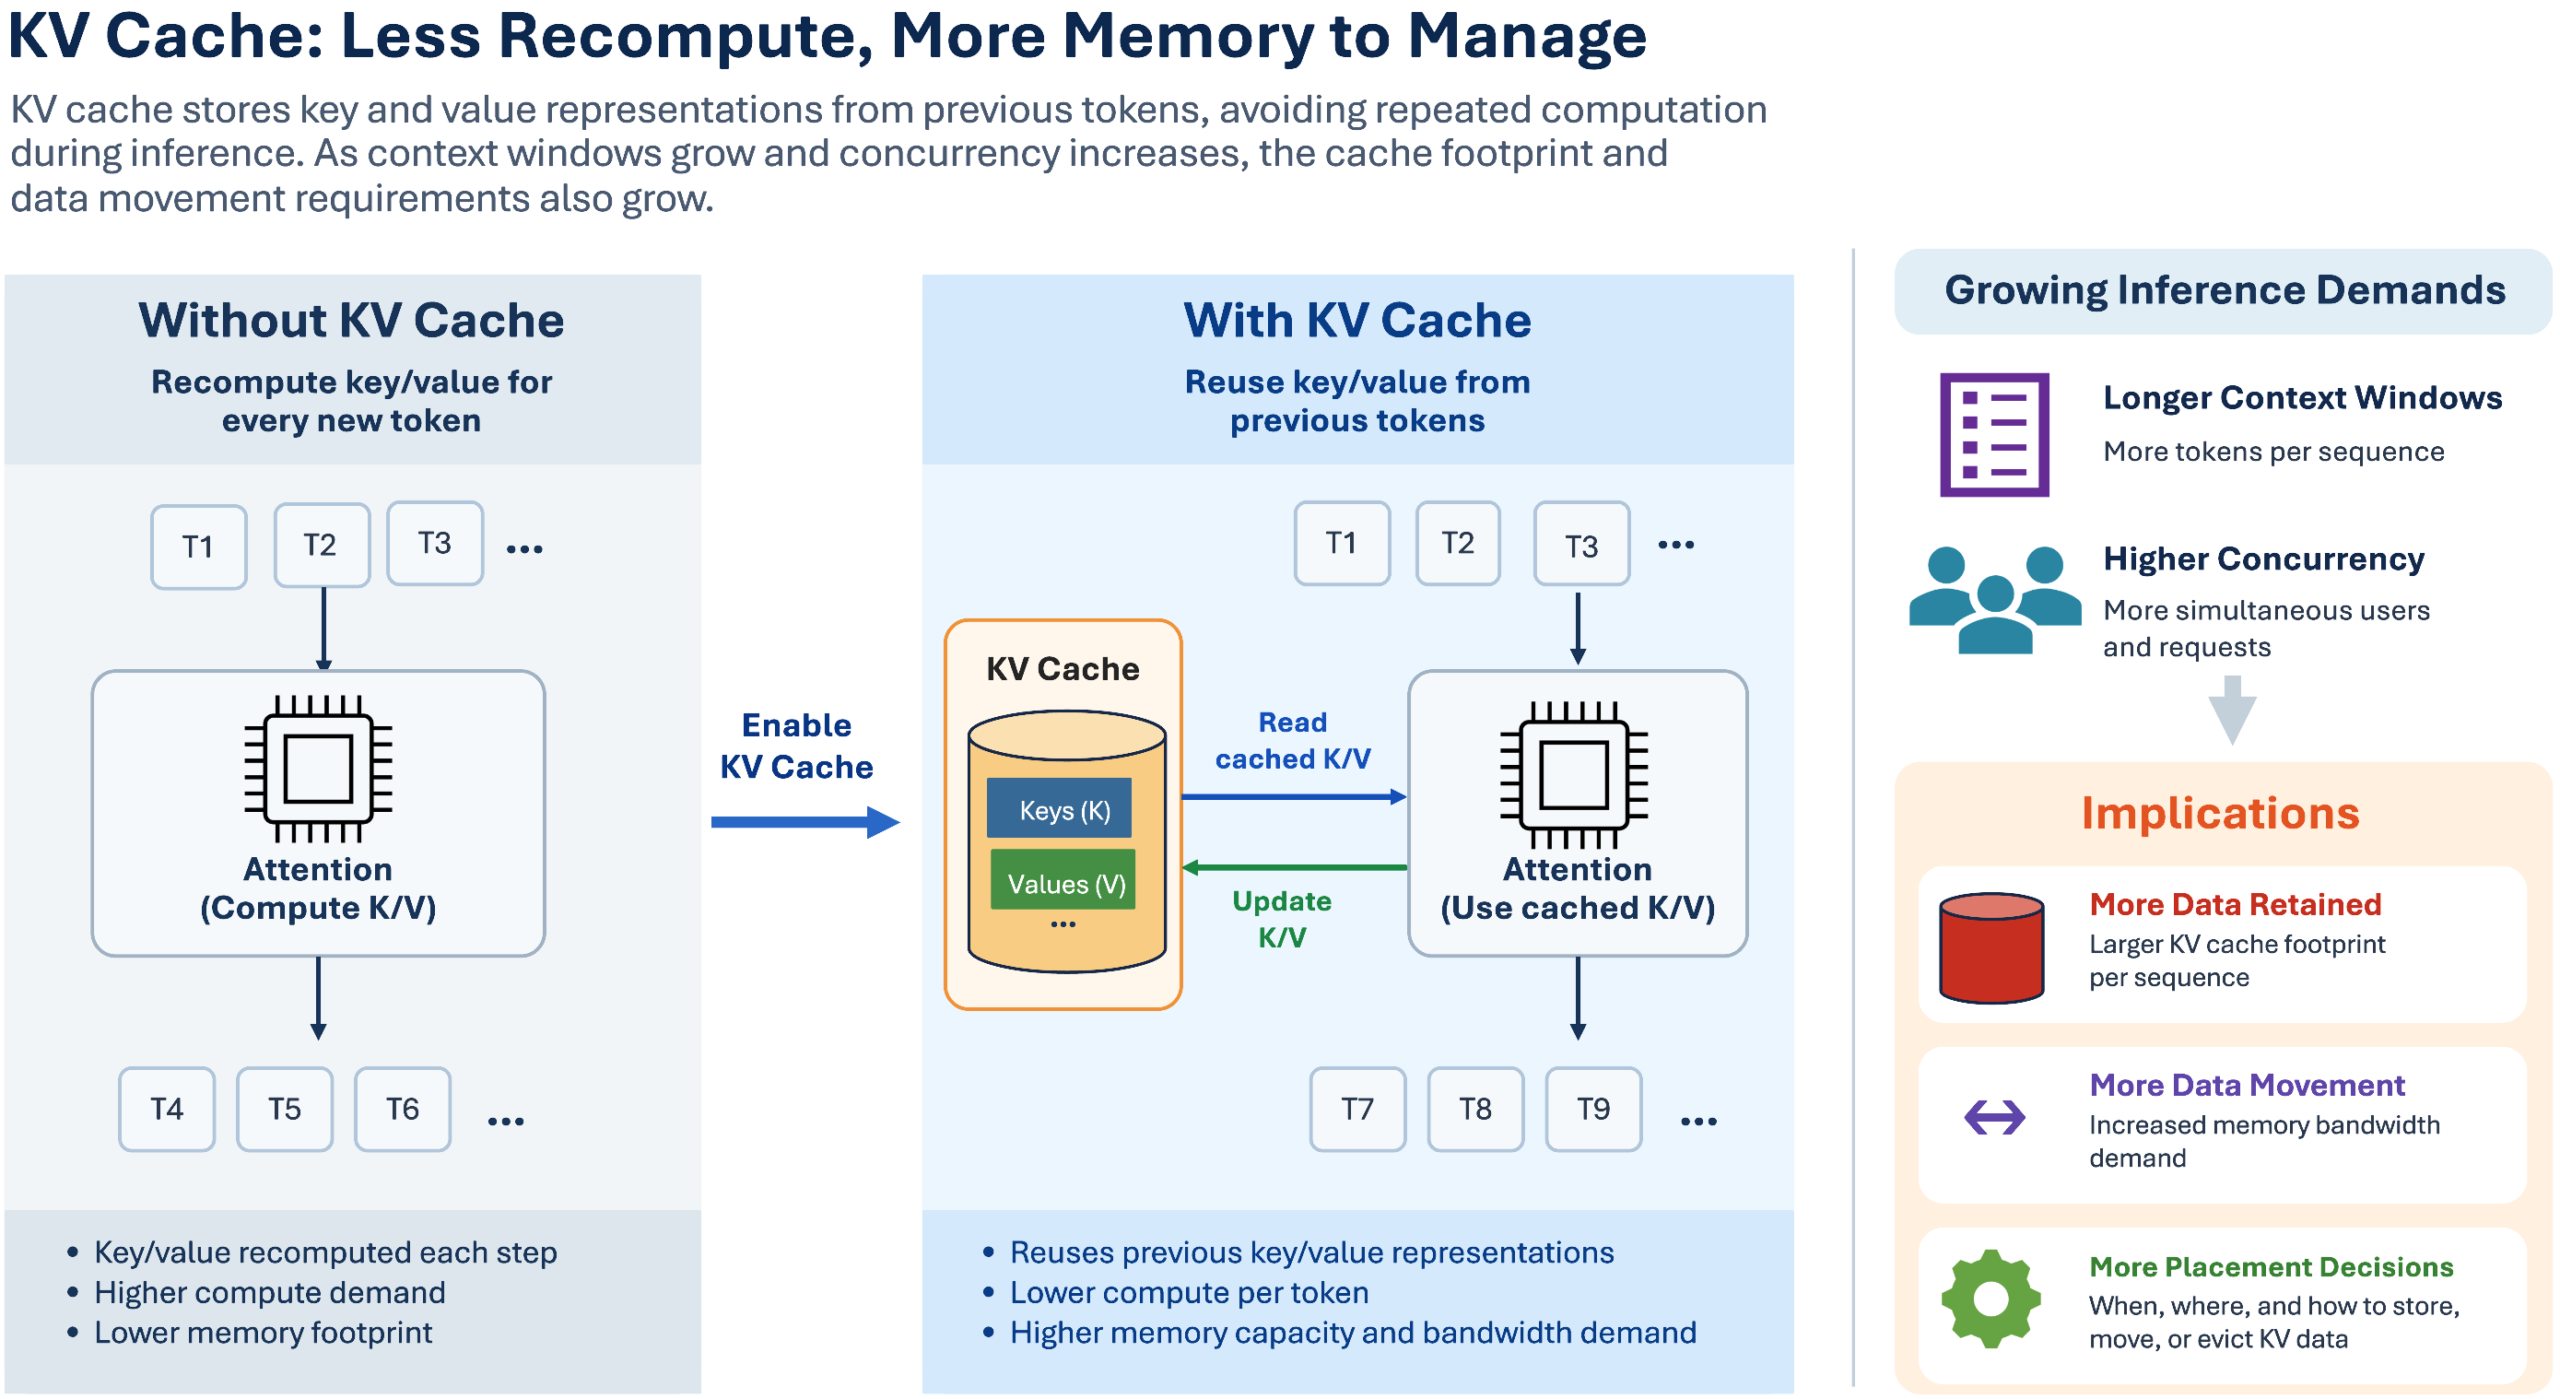
在Transformer推理过程中,注意力机制会为序列中的词元生成键和值表示。保留这些表示可使后续解码步骤复用先前状态,而不必为较早词元重新计算。这提升了推理效率,但在减少重复计算的同时,也增加了对内存容量和数据移动的压力。
更长的上下文窗口会增加每个序列的KV缓存占用。更高并发会在同时发生的请求之间成倍放大这一需求。因此,一项旨在降低计算需求的优化,反而会产生更多必须保留和访问的数据。
图2:减少重复计算可提升效率,但更长上下文和更高并发会增加需要保留、移动和管理的数据。
KV状态还有生命周期。它在预填充阶段创建,在解码阶段被反复访问,并可能被保留以供复用。根据服务架构不同,它可能被移动、复制、压缩或清除。每个阶段都会对带宽、容量、时延和控制提出不同要求。
因此,KV缓存是数据生命周期问题,而不仅是内存分配问题。只有当迁移到较低成本层级所释放的高层级容量,或避免重复计算带来的收益,超过传输时延、带宽消耗、能耗以及未达SLO的风险时,将KV状态移至更低成本层级才有益。换言之,每一次数据移动都必须值回其成本。
工作负载决定架构
对时延敏感的助手可能受益于将频繁访问的数据保存在加速器附近。长上下文企业应用可能更重视容量。AI智能体可能需要更长时间保存状态,并更频繁复用。大规模消费者推理可能优先考虑吞吐量、利用率和每词元成本。
频繁访问的数据可能有必要驻留在计算附近。其他数据可能可以容忍额外时延,以换取更大容量或更低成本,或者随着访问模式变化在层级之间移动。目标不是消除内存层级,而是高效协调这一层级。
没有单一的内存指标
带宽仍然关键,但只针对带宽进行优化会忽视其他约束。容量决定有多少模型和推理状态可以保持可访问。时延影响响应时间。功耗决定不断增加的数据移动是否可持续。利用率表明昂贵的计算资源是在工作还是在等待数据。
很高的总吞吐量可能掩盖难以接受的首词元时间、词元间时延,或拥塞期间的尾时延。更有意义的衡量方式可能是在满足时延目标的同时,每瓦或每美元可生成多少词元。仅靠标称带宽无法解决内存墙。
真正相关的问题是:哪种计算、内存、互连和软件组合,能在可用功耗和成本范围内提供可预测性能?
仅增加内存还不够
高带宽内存可以在加速器附近快速供应数据。在容量比最大带宽更重要的场景中,更大容量层级可以形成补充。扩展和池化可以提供加速器旁内存之外的容量。软件可以根据工作负载要求放置、复用、压缩、移动或丢弃KV状态。
但每增加一个层级,都会带来更多决策。一个有用的架构必须解决四个问题。在放置方面,需要判断哪些数据必须留在计算附近,哪些数据可以容忍更远的层级。在移动方面,需要判断何时传输数据比重复计算更高效。在协调方面,需要解决加速器、内存控制器、互连和软件如何在不造成拥塞的情况下协调数据放置与移动。在保障方面,需要解决当推理状态跨越更多边界时,系统如何保持可靠性、隔离性、数据完整性和可预测性能。
将数据移动到更大容量层级可能增加有效容量,但也会增加时延。复制状态可以避免重复计算,但会在其他地方消耗带宽和容量。池化可以提高利用率,但前提是资源竞争和服务质量保持受控。优势并不来自最大化某一项内存规格,也不来自简单增加另一个层级,而是来自把整个层级作为系统来协调。
内存墙会持续移动
更高带宽内存、更大容量、更快互连、压缩和更智能的缓存管理可以缓解约束,但无法消除挑战。当一个瓶颈改善时,应用和模型会利用额外资源。更长上下文、更高并发、多模态模型以及日益复杂的AI智能体,将继续改变内存压力出现的位置。因此,软硬件协同设计至关重要,因为每一层都会影响数据移动。
下一阶段AI基础设施扩展不会仅由算力定义,也不会仅靠增加内存解决。更难的任务是协调推理数据存放在哪里、何时移动,以及移动它是否比重复计算更高效。内存墙正在变成更广泛的问题:它考验的是系统能否有效地将分布式内存资源转化为可预测的AI性能。
来源: 海外媒体


登录后即可参与技术讨论与同行交流
免费注册