3D芯片行业有些概念,越宣传,边界越模糊。
存储叠到计算上面,叫三维集成;数据搬运距离缩短,叫近存优势。讲着讲着,“近存”就变成了“存算”,仿佛只要芯片摞得够紧,存储便自动获得了计算能力。
但工程上没有这种自动升级。
值得警惕的宣传混淆,是把集成方式当成计算方式,把带宽优势讲成存内计算优势。介绍了半天堆叠层数、互连密度和访存性能,却没有回答最基本的问题:
这里的“存算”,究竟对应什么计算机制?
带宽可以用来证明互连能力,不能代替CIM电路的证据。
要把这件事讲明白,需要区分三条技术路线。常规计算单元与存储的3D近存集成、底层采用SRAM CIM的3D存算,以及以3D RRAM等为代表的存储层三维存算。
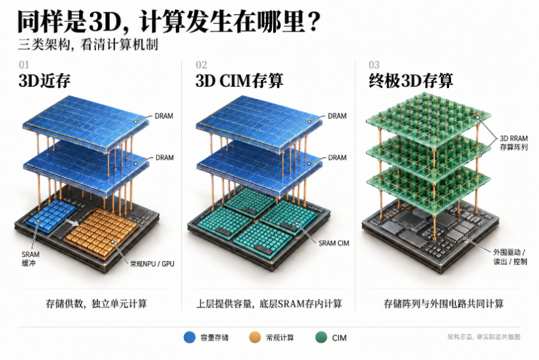
| 3D近存:架构容易复刻,别把通用思路包装成独门架构
第一类的基本思路很简单:上面放存储,下面放常规NPU、GPU或专用计算逻辑,通过三维互连把两者连接起来。
存储负责供数,计算单元负责运算。数据搬运的路径缩短了,接口可以做得更宽,但计算方式并没有因此变成CIM。
把计算放到三维存储附近,早已是公开研究的路线,并不是谁把上下两块方框重新画一遍,就能认领一次架构革命。
照着画一张3D架构很容易。真正的技术差异,不会因为多写几个形容词就长出来。
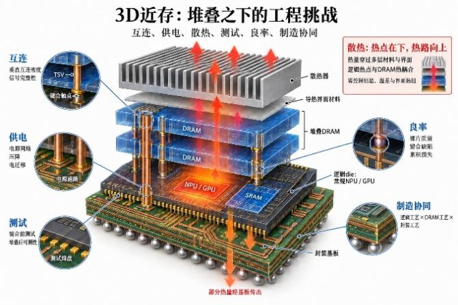
架构思路简单,不等于芯片工程简单。互连、供电、散热、测试、良率和制造协同,仍然需要扎实投入。但如果底层仍是常规计算单元,没有SRAM CIM,上层存储也没有CIM机制,那么这条路线的准确技术描述,就是3D近存。
| 3D+SRAM CIM:这里有门槛,而且不是所有CIM都一样
第二类表面上也是上层DRAM、底层逻辑die,但底层内部已经不同:承担相关运算的是SRAM CIM宏,而不是普通缓存向独立乘加单元供数。
DRAM提供容量,SRAM CIM承担特定计算。三维互连与存内计算各自发挥作用。
真正的门槛在宏电路、数据流和系统实现里。
同样写着“SRAM CIM”,有的采用数字实现,有的采用模拟或混合实现;不同方案在精度、能耗、面积和数据流灵活性上有不同取舍。相关研究已经专门建立模型,从能耗、吞吐到完整网络运行效率比较这些差异。
CIM是技术路线,不是性能合格证。
评价一套CIM,至少要追问四件事。
第一,精度是否一致。低位宽条件下的漂亮数字,不能直接拿来证明高精度任务的优势。
第二,开销是否算全。外围读出、转换、累加、控制和数据搬运,不能在报告能效时集体消失。
第三,阵列是否用得起来。模型映射后,大量计算资源如果闲置,峰值算力就只能停留在规格表上。
第四,宏的优势能否传到系统。单个宏的能效、整颗芯片的能效和完整应用的能效,是三份不同的成绩单。
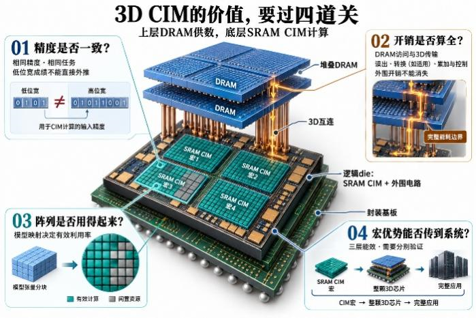
把CIM做出来是一道门槛,把CIM做得有效是另一道。拿一个宏的最好成绩,替整个系统交卷,是宣传,不是评测。
三维堆叠不会自动修好一套低效的CIM。宏设计、访存组织或算子适配出了问题,堆得再紧,也只是把问题放得更近。
微纳核芯长期专注于三维存算一体AI芯片研发,构建了 3D-CIM™技术体系。这一体系并非单纯采用三维堆叠或先进封装,而是将存内计算、三维近存堆叠和AI计算架构进行协同设计。
一方面,三维集成能够提升存储与计算之间的连接效率;另一方面,存内计算则尝试将部分AI计算下沉至存储单元或存储阵列附近,从而减少大模型推理过程中的数据搬运。二者结合,带来的不只是物理距离上的缩短,也包括计算位置、数据流动方式和系统架构的重新组织。
这种架构的核心价值在于,它不是简单地“把存储器搬近计算单元”,而是尝试重新定义计算发生的位置,让数据在更接近存储的位置完成计算。对于大模型推理而言,这种方式有望在算力密度、功耗、延迟和系统集成度之间取得更好的平衡。
另一项探索,是没有将存算一体局限于单一硬件单元,而是同步构建了 RV-CIM™异构全栈技术体系。该体系基于RISC-V指令集扩展,围绕存算一体芯片的特点,对处理器架构、专用指令集、核心IP、编译器、运行环境和算法适配进行协同设计。
传统AI芯片通常是在既有计算架构上增加AI加速单元,而存算一体芯片需要解决更加复杂的问题:存储阵列如何参与计算,通用计算与专用计算如何协同,现有大模型如何迁移,以及软件开发者如何调用新的计算资源。
RV-CIM™的意义,在于尝试通过指令集和软件工具链,将存算单元从相对固定的专用硬件模块,转化为可编程、可调度、可适配的异构计算资源。这样一来,存算一体芯片就不只是针对某一类固定任务提供加速,而是有机会通过软硬件协同,适配更加广泛的人工智能推理场景。
从技术架构来看,微纳核芯探索的是一条“3D集成+存内计算+异构架构+全栈软件”的融合路线。其中,三维堆叠是系统集成的基础,存内计算是降低数据搬运的核心机制,RISC-V异构指令架构和软件工具链则承担着提升通用性、可编程性和生态适配能力的作用。
这也是该路线区别于单纯3D近存方案的地方:它关注的不只是存储器与处理器之间的物理距离,更关注数据如何流动、计算如何调度,以及芯片如何真正服务于大模型推理等实际应用。
从全球技术发展来看,存算一体仍处于技术路线持续探索和加速分化的阶段。微纳核芯将三维存算、异构指令架构与软件栈进行一体化设计,体现了从单点硬件创新走向系统级架构创新的思路,也为存算一体芯片从实验室技术走向产业化应用提供了一条具有差异化的探索路径。
目前,微纳核芯相关技术已完成多轮流片验证,并面向AI手机、AI PC、云端智算、AI机器人和边缘计算等场景推进应用探索。对于这类新型芯片架构而言,技术创新的最终目标并不只是完成一颗芯片,而是让芯片能够进入真实应用,形成稳定的产品能力、软件生态和产业协同。
| 存储层3D CIM:有前景,但还不能按成熟产品讲故事
第三类进一步把存储器件、阵列与计算机制结合起来。以3D RRAM存算为例,存储状态参与权重表示,阵列与外围电路共同实现特定运算,再通过三维结构扩展存算资源。
它的难度已经超出“把两颗芯片叠起来”。
器件要稳定,阵列要一致,计算要准确,工艺要兼容。层数增加之后,还要处理层间差异、互连寄生、读出、校准和热管理。存储单元能够可靠地存住数据,不代表它天然适合稳定、可重复的计算。
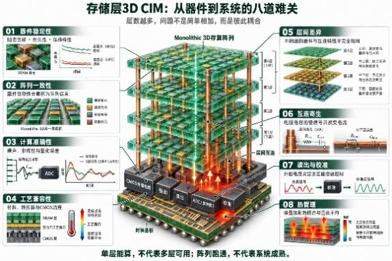
已有研究展示了三维垂直RRAM的CIM宏,证明了路线的可行性;但从实验宏走向可扩展系统,还需要器件、单元设计和集成方式共同突破。
这条路线目前仍以学术研究和原型验证为主,尚不能笼统视为成熟的大规模商用方案。
论文中的阵列跑通了,不等于量产良率已经解决;小规模演示准确,不等于扩大规模之后仍能保持精度;器件指标漂亮,也不等于外围电路和系统成本可以忽略。
研究成果值得尊重,但实验室的可行性,不能提前兑换成产业化的确定性。
行业最该停止的,是拿三条路线的长处拼一张宣传海报。
不能拿第一类的直观架构,讲第二类的CIM收益,再借第三类的器件想象力,最后给出一个笼统的“3D存算领先”。
近存的优势,要用访存与系统数据证明;SRAM CIM的门槛,要用宏电路和应用表现证明;存储层3D CIM的进展,要用可重复实验和工程成熟度证明。
第一类,别把容易复刻的架构思路当成独门发明;第二类,别把“有CIM”当成“CIM做得好”;第三类,别把论文原型当成现成产品。
行业需要的是把各自的难题解决,而不是把各自的边界说没。
技术门槛在电路、工艺和系统里,而不在“3D存算”这四个字里。
评论区
登录后即可参与讨论
立即登录